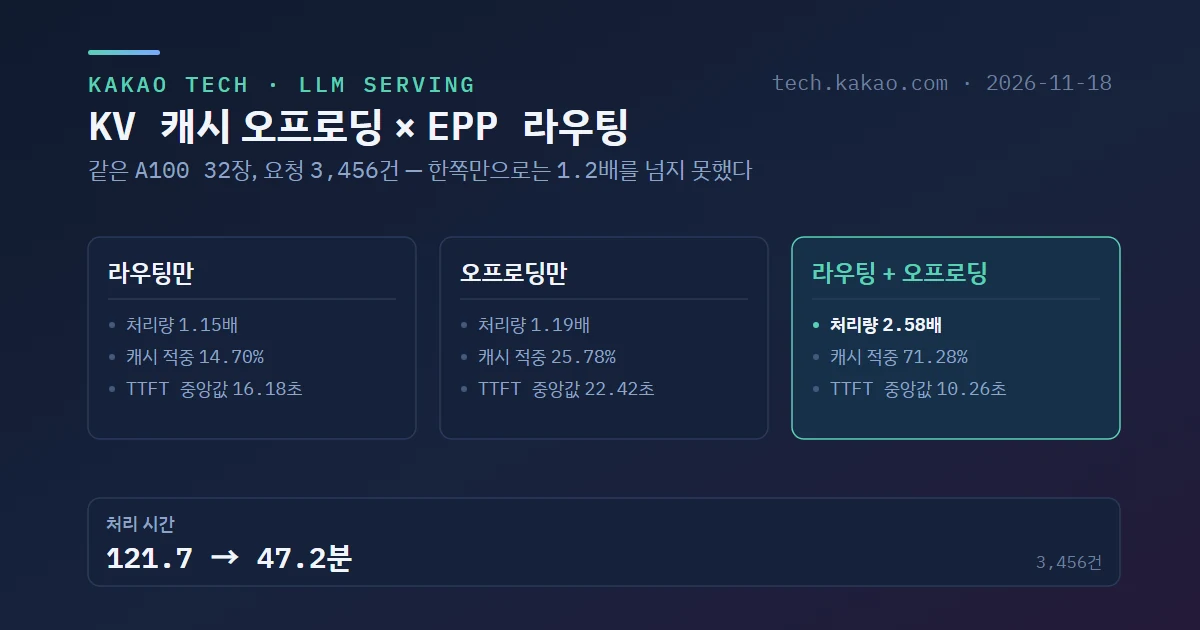
카카오 테크: 같은 GPU로 더 많은 요청 처리하기, KV 캐시 오프로딩 × EPP 라우팅
카카오 AI플랫폼팀이 vLLM으로 서빙하는 32B 모델에서 GPU도 모델도 그대로 둔 채 요청 처리량을 2.58배로 올린 실험을 공개했다. 바꾼 것은 두 가지다. GPU에서 밀려난 KV 캐시를 CPU 메모리와 로컬 NVMe에 남겨 두는 오프로딩(LMCache)을 붙였고 같은 문서를 묻는 다음 요청이 그 캐시가 남아 있을 법한 파드로 가도록 EPP 라우팅을 붙였다. 한쪽만 적용했을 때는 1.2배에도 못 미쳤다는 점이 이 글의 요지다. (이 글의 초안은 설치된 Hermes 에이전트가 작성했고, Claude가 검수 후 발행했다.)
TL;DR: A100 80 GB 32장, 요청 3,456건 조건에서 처리 시간이 121.7분에서 47.2분으로 줄었다(처리량 2.58배). 오프로딩만 적용하면 1.19배, 라우팅만 적용하면 1.15배였다. 2.58배는 EPP approximate 라우터의
autoTune을 끄고 인덱스 용량을 키운 조건에서 나온 값이며 기본 설정을 그대로 켠 결과가 아니다. 모든 수치는 방식마다 한 번씩 잰 것이라 원문도 2.58배를 보장값으로 제시하지 않는다. 따라 해 볼 만한 것은 LMCache 디스크 읽기의use_odirect, 복사 버퍼의 NUMA 고정,nvidia-smi topo -m·lspci -tv로 NVMe와 PCIe 경로를 공유하는 GPU 확인하기다.
원문은 2026년 11월 18일 카카오 테크 블로그에 올라온 같은 GPU로 더 많은 AI 요청을 처리할 수 있을까? ― KV 캐시 오프로딩 × EPP 라우팅이다. 실험은 모두 서비스와 분리된 실험 노드에서 했고 모델과 하드웨어도 실제 서비스와 다르다고 원문은 밝힌다.
원문 근거
"결론부터 말씀드리면, GPU 캐시만으로는 문서를 모두 담을 수 없는 실험 3에서 오프로딩만 적용하면 처리량이 1.19배, 라우팅만 적용하면 1.15배에 그쳤고, 둘을 함께 적용하자 2.58배가 됐습니다."
KV 캐시를 재사용하지 못하는 두 가지 이유
LLM 추론은 입력을 처리하는 프리필과 출력 토큰을 하나씩 만드는 디코드로 나뉜다. 프리필 때 어텐션이 참조하는 키와 값을 저장해 둔 것이 KV 캐시다. 다음 요청의 앞부분(프리픽스)이 이전 요청과 토큰 단위로 정확히 같으면 vLLM의 프리픽스 캐싱이 그 구간의 프리필을 건너뛴다. 원문 측정으로는 3만 2천 토큰 프리픽스를 GPU 캐시에서 이어 쓰면 첫 토큰이 104 ms 만에 나오고, 처음부터 계산하면 2,841 ms가 걸린다.
문제는 KV의 크기다. 실험에 쓴 32B 모델은 64개 층, KV 헤드 8개, 헤드 차원 128이고 FP8로 저장하면 토큰 하나에 128 KiB가 든다. 6만 5천 토큰 문서 하나가 약 8 GiB다. GPU 메모리에는 모델 가중치와 실행 중인 요청의 상태도 올라가니 KV를 오래 붙잡아 둘 수 없다.
그래서 재사용은 두 곳에서 끊긴다.
- GPU에서 밀려날 때: 다른 문서를 많이 처리하면 이전 KV가 밀려난다. 오프로딩은 밀려난 KV를 CPU 메모리와 디스크에 남겨 둔다.
- 다른 파드로 갈 때: 같은 문서의 다음 질문이 다른 파드로 가면 그 파드에는 KV가 없다. 라우팅은 KV가 있을 가능성이 높은 파드로 요청을 보낸다.
여기서 파드는 모델 복제본 하나를 실행하는 서빙 단위이고, 파드마다 KV 캐시는 독립적이다.
실험 1: 단일 노드에서 오프로딩만, 3.56배
LMCache의 CPU 메모리 캐시를 L1, 로컬 NVMe SSD의 디스크 캐시를 L2로 두었다. A100 8장에 모델 하나를 나눠 올린 파드(TP8) 하나에서 GPU 캐시에는 문서 약 22개, CPU 캐시에는 약 96개가 들어가게 맞추고 시험 문서를 108개로 정해 세 계층이 모두 일하게 했다.
| 구성 | 요청 처리량 |
|---|---|
| GPU 캐시만(기준선) | 1.00배 |
| + CPU 캐시 | 2.47배 |
| + 디스크 캐시 | 3.26배 |
| + MP(multi-process) 방식 | 3.56배 |
원문 근거
"GPU KV 용량은 그대로 둔 채 CPU 캐시를 붙이자 요청 처리량이 2.47배가 됐고, 디스크 캐시까지 더하자 3.26배, MP 방식으로 옮기자 3.56배가 됐습니다."
다시 계산한 입력 토큰의 비율은 81%에서 13.5%로 내려갔다. 문서를 처음 볼 때와 매번 다른 질문은 어차피 계산해야 하므로 이 부하의 바닥은 약 13%이고 사실상 바닥에 닿았다. 디스크 캐시까지 붙인 단계에서는 입력 토큰의 약 56%를 CPU 캐시에서, 약 12%를 디스크 캐시에서 가져왔다.
원격 캐시는 이번 구성에서 뺐다. Redis와 S3 호환 오브젝트 스토리지를 25 GbE로 시험했더니(이 시험의 KV는 BF16, 토큰당 256 KiB) 측정한 모든 길이에서 가져오는 쪽이 재계산보다 느렸다. 4만 토큰 요청 하나의 KV를 옮기는 데만 약 3.64초, 조회와 복원까지 더하면 4.26초로 재계산(4.17초)보다 길었다. 오브젝트 스토리지 읽기는 25 GbE 이론 대역폭의 92~94%를 이미 쓰고 있었고 Redis는 Redis 쪽 처리가 먼저 막혀 약 8 Gbps에 머물렀다. 원문은 더 넓은 네트워크와 FP8 KV로 다시 재 보겠다고 적었다.
복원 경로에서 고친 세 가지
3.56배는 캐시를 붙이기만 해서 나온 숫자가 아니다. 부록에 병목 세 곳을 고친 과정이 있고 같은 스택을 쓰는 사람이 바로 확인해 볼 수 있는 부분이 여기다.
디스크 읽기 방식. 디스크만 따로 재면 6 GB/s를 읽는데 서빙 중에는 약 2.6 GB/s에서 멈췄다. 원인은 LMCache의 기본값인 buffered I/O였다. 페이지 캐시를 거치며 데이터를 한 번 더 복사했고 8 MiB 묶음을 커널이 128 KiB씩 나눠 요청했다. O_DIRECT를 켜고 스레드를 8개로 두자 4.74 GB/s가 됐다. 원문에 실린 설정은 다음과 같다.
# 실험에 사용한 디스크 설정 일부 (in-process 방식)
extra_config:
  use_odirect: true    # 기본 false. 페이지 캐시 없이 8 MiB 청크를 통째로 읽고 씀
  disk_io_threads: 8    # 기본 4
  chunk_size: 512       # 512토큰 × GPU 한 장당 16 KiB = 8 MiB
복사 버퍼의 NUMA 위치. 새 KV를 외부 캐시에 저장하는 시간의 95.7%가 GPU에서 CPU 고정 메모리(pinned memory)로 복사하는 첫 단계에 들었다. vLLM 워커가 특정 CPU에 묶여 있지 않아 버퍼가 반대편 소켓 메모리에 잡히는 경우가 있었고 한 회차에서는 GPU 8장 중 4장이 그랬다. 8장이 다 함께 느려져 GPU 간 차이가 1.15배뿐이라 경고도 나지 않았다. in-process 방식에서는 numa_mode: auto로, MP 방식에서는 캐시 서버를 소켓마다 하나씩 두고 numactl로 묶어 해결했다. 복사 속도는 2.80 GB/s에서 5.32 GB/s로 올랐다. 다만 그 시험의 전체 처리량은 2.9%만 올랐다. GPU 캐시 적중이 높아 복사가 일어나는 요청이 많지 않았기 때문이다.
엔진 스텝을 막는 복원. in-process 방식은 KV 복원을 vLLM 엔진 스텝 안에서 동기로 처리해 128K 문서를 디스크에서 읽는 동안 옆 요청까지 최대 4.07초 멈췄다. 캐시 서버를 별도 프로세스로 띄우는 MP 방식으로 바꾸자 외부 KV를 기다리는 요청만 대기열로 빠졌고 같은 캐시 용량에서 요청 처리량이 9.0% 올랐다. 원문은 MP를 고른 이유를 하나 더 든다. 소규모 정답 검사에서 시험한 in-process 구성은 캐시를 거친 답 일부가 GPU 경로의 답과 달랐고 빈 응답이 HTTP 200에 정상 토큰 수로 섞여 있었다. 특정 시험 구성에서 본 현상이고 라이브러리 전체에 대한 결론은 아니라고 원문은 선을 긋는다. 캐시를 쓰는 서빙이라면 성능 측정과 별도로 정답 검사를 함께 돌리라는 것이 원문의 권고다.
실험 2: 라우팅만, 1.87배
Round Robin은 요청 수만 고르게 나누고 요청 안에 어떤 문서가 들었는지는 보지 않는다. 같은 문서의 질문이 여러 파드로 흩어지고 같은 KV가 여러 벌 저장되어 GPU 메모리도 빨리 찬다.
EPP(Endpoint Picker)는 게이트웨이가 요청을 보내기 직전에 어느 파드로 보낼지 정하는 구성 요소다. 파드마다 세 가지 점수를 매겨 가중합이 가장 높은 파드를 고른다.
| 점수 | 뜻 |
|---|---|
| 프리픽스 | 그 파드가 이 요청의 앞부분을 가진 것으로 보이는 비율 |
| 대기열 | 기다리는 요청이 적을수록, 파드끼리 견줘 가장 한가할수록 높음 |
| GPU KV | GPU KV 캐시에 여유가 있을수록 높음 |
EPP는 파드의 캐시를 직접 들여다보지 못한다. approximate 방식은 어떤 프리픽스를 어느 파드로 보냈는지 인덱스에 적어 두고 추정한다. 가볍지만 그 뒤 KV가 지워졌는지는 모른다. precise 방식은 서빙 엔진이 내는 KV 저장·삭제 이벤트로 실제 상태를 따라간다. 정확하지만 이벤트를 내지 않는 계층은 보지 못한다.
실험 2는 H100 80 GB 2장에 모델을 나눠 올린(TP2) 파드 6개를 썼다. 6천 토큰 문서 190개에 1,200토큰 질문을 5개씩 붙였고 공통 문서와 질문 KV의 합이 파드 6개 GPU 캐시 합계의 약 73%가 되게 맞췄다. 겹치지 않게 나누면 다 들어가고, 흩어지면 넘치는 크기다.
| 라우터 | GPU 캐시 적중률 | 요청 처리량 |
|---|---|---|
| Round Robin | 27.7% | 1.00배 |
| EPP | 90.5% | 1.87배 |
다시 계산한 입력 토큰은 약 2,530만 개에서 340만 개로 줄었다. 이 조건에서는 approximate와 precise가 1.82~1.87배로 비슷했다. 두 방식의 차이는 문서가 GPU 캐시를 크게 넘는 실험 3에서 벌어진다.
EPP를 켰더니 Round Robin보다 느렸던 초기 설정
라우팅 효과가 처음부터 나온 것은 아니다. 대기열 점수의 입력을 기본값인 대기 중 요청 수(num_requests_waiting) 대신 실행 중 요청 수(num_requests_running)로 넣었더니 요청이 한 파드로 몰렸다. EPP는 파드별 요청 수를 50 ms마다 받아 오고 그 사이에는 마지막 값을 그대로 쓰는데, 방금 보낸 요청은 그 값에 더하지 않는다. 대기열 점수는 파드끼리 견주는 상대 점수라 실행 중 요청이 12건과 13건처럼 한 건만 달라도 1점과 0점으로 벌어진다. 초당 40건 구간에서 출력 처리량이 13,725 tok/s에서 3,453 tok/s로 떨어졌고 입력을 기본값으로 되돌려 해결했다. 이런 설정은 잘못 두어도 오류 없이 성능만 떨어지므로, 라우터를 바꿀 때는 Round Robin 대조군을 함께 재 두라고 원문은 권한다.
실험 3: 오프로딩과 라우팅 결합, 2.58배
A100 80 GB 32장을 파드 4개(TP8)로 나누고 6만 5천 토큰 문서 432개에 질문을 8개씩 붙여 모두 3,456건을 처리했다. 처리 중인 요청이 늘 64건이 되게 유지했다(동시성 64). 부하는 라우팅만 켜도, 오프로딩만 켜도 다 담기지 않고 둘을 함께 켜야 파드 하나의 몫(문서 108개)이 캐시에 들어가는 크기로 잡았다.
| 구성 | 요청 처리량 | E2E 중앙값 | TTFT 중앙값 / p95 | 전체 입력 캐시 적중 |
|---|---|---|---|---|
| Round Robin(기준선) | 0.473 req/s | 141.35초 | 22.33 / 56.92초 | 4.20% |
| EPP approximate만 | 0.547 req/s | 115.68초 | 16.18 / 39.93초 | 14.70% |
| EPP precise만 | 0.513 req/s | 126.24초 | 21.85 / 55.70초 | 8.36% |
| Round Robin + 오프로딩 | 0.565 req/s | 117.58초 | 22.42 / 60.88초 | 25.78% |
| EPP precise + 오프로딩 | 0.617 req/s | 102.15초 | 21.92 / 61.35초 | 27.70% |
| EPP approximate + 오프로딩 | 1.219 req/s | 48.42초 | 10.26 / 37.36초 | 71.28% |
라우팅만 바꾸면 1.15배(precise는 1.08배), 오프로딩만 붙이면 1.19배였고 둘을 함께 적용하자 2.58배가 됐다. 원문의 설명은 이렇다.
- 라우팅만 적용하면 같은 문서를 한 파드로 모을 수는 있지만 그 파드가 담을 수 있는 양은 여전히 문서 22개 정도다.
- 오프로딩만 적용하면 캐시 적중률은 25.78%로 올랐는데 TTFT 중앙값은 기준선과 거의 같았고 p95는 오히려 나빠졌다. Round Robin이 같은 문서를 네 파드에 흩어 보내니 파드마다 432개 문서를 다 담으려다 새 KV가 기존 KV를 계속 밀어냈다. 적중률이 올랐다고 지연도 줄었다고 보면 안 되는 예다.
- 오프로딩은 KV를 둘 공간을 만들고, 라우팅은 그 공간에 들어갈 만큼 짐을 줄인다.
approximate가 precise를 앞선 이유와 인덱스 설정
precise + 오프로딩은 1.30배에 그쳤다. 이번 실험 구성에서 precise는 GPU 캐시의 저장·삭제 이벤트만 받았다. KV가 GPU에서 밀려나면 EPP는 그 문서가 어디에도 없다고 판단하고 파드의 CPU·디스크에 KV가 남아 있어도 다른 파드를 골라 다시 계산할 수 있다. approximate는 인덱스 용량 안에서는 보낸 기록을 지우지 않으므로 같은 문서를 같은 파드로 더 오래 모았다. 다만 두 방식은 점수 가중치(1:1:1과 3:2:2)가 달랐고 블록 크기가 맞았는지도 확인하지 못해 원문은 원인을 이것 하나로 확정하지 않는다.
approximate 쪽도 기본 설정으로는 이 결과가 나오지 않는다. 기본 autoTune은 인덱스 크기를 GPU 캐시 용량에 맞추므로, CPU·디스크에 KV가 남아 있어도 그 파드로 보낸 기록이 먼저 지워질 수 있다. 실험에서는 autoTune을 끄고 인덱스를 키웠다.
# 실험에 사용한 approximate producer 설정 일부
- type: approx-prefix-cache-producer
parameters:
  autoTune: false
  blockSizeTokens: 16
  maxPrefixBlocksToMatch: 1024  # 약 16K 토큰만 해시
  lruCapacityPerServer: 500000  # 파드당 약 488문서 분량
원문 근거
"이때 approximate와 오프로딩을 결합한 구성은 CPU·디스크에 남은 KV의 위치도 오래 기억할 수 있도록 라우터의 인덱스 용량을 늘렸습니다. 따라서 아래 결과는 기본 설정을 그대로 켠 효과가 아니라, 이 조건을 함께 적용한 결과입니다."
원문은 이 설정을 운영 해법이 아니라 실험 조건이라고 못박는다. 캐시 크기나 문서 길이가 바뀌면 용량을 사람이 다시 계산해야 하고, 오래 기억하는 만큼 이미 지워진 KV를 후보로 남길 수 있으며, EPP를 다시 띄우면 기억이 사라진다. 인덱스가 크다고 늘 좋은 것도 아니다. 캐시의 수명과 라우터의 기억이 얼마나 맞는지가 성능을 좌우한다.
TTFT보다 TPOT가 더 줄었다
프리픽스 캐싱은 보통 첫 토큰까지의 시간(TTFT)을 줄이는 기술로 알려져 있는데, 이번에는 첫 토큰 이후 구간이 더 많이 줄었다. 요청별 평균 TPOT(토큰 사이 간격)의 중앙값이 224.91 ms에서 65.48 ms로 내려갔다. 원문은 긴 입력의 재계산이 줄면서 동시에 답변을 생성하던 요청들의 GPU 자원 경쟁도 완화된 것으로 본다.
원문 근거
"요청별 평균 TPOT의 중앙값은 224.91 ms에서 65.48 ms로 약 71% 감소했습니다."
숫자를 읽을 때 주의할 점
원문이 직접 붙인 단서가 네 가지 있다.
- 오래 기다린 요청의 지연은 덜 줄었다. E2E p95는 210.80초에서 95.67초로, TTFT p95는 56.92초에서 37.36초로 줄었지만 p99는 75.18초에서 59.11초로 21.4% 줄어드는 데 그쳤다.
- 처음부터 빠르지 않았다. 약 5분 단위 처리량은 초반 약 0.50 req/s에서 최고 약 1.55 req/s까지 올랐다가 후반에 약 1.24 req/s로 내려왔다. 라우터가 배치 이력을 쌓고 캐시 내용이 그 선택에 맞춰 바뀌는 시간이 필요했다.
- GPU 절감으로 바꿔 읽으면 안 된다. 같은 GPU로 2.58배를 처리했다고 필요한 GPU가 2.58분의 1이 되지는 않는다. 파드 수를 바꾸면 파드당 부하, 캐시 용량, 중복 저장, 분배가 함께 바뀐다.
- 모든 수치는 방식마다 한 번씩 측정했다. 결합 실험은 캐시와 인덱스의 초기 상태를 방식마다 똑같이 맞췄는지 기록만으로 확인하지 못해 원문은 2.58배를 보장값으로 제시하지 않는다.
하드웨어 배치가 만든 병목과 배포 전 점검 항목
실험 3을 재는 동안 병목이 하나 더 나왔다. 디스크를 읽는 동안 특정 GPU 두 장(GPU 2·3)만 CPU 메모리에서 KV를 받는 속도가 떨어졌다. 디스크를 많이 읽는 부하에서는 0.7~1.4 GB/s로 나머지(약 14 GB/s)의 10분의 1 수준이었다. lspci와 nvidia-smi topo -m 출력으로 배치를 다시 그려 보니 두 GPU는 NVMe와 같은 PCIe 루트 포트 아래에 있었다. NVMe가 하나뿐이라 소켓 1의 캐시 서버도 소켓 0에 붙은 이 NVMe를 읽었다. TP8에서는 모든 GPU가 자기 조각을 받아야 복원이 끝나므로 가장 느린 GPU가 전체 복원 속도를 정한다.
NVMe가 읽은 데이터를 같은 소켓 메모리에 쓸 때는 1%밖에 느려지지 않았다. 반대 소켓 메모리에 쓰는 작업이 섞이면 달라졌다.
원문 근거
"그런데 NVMe에서 읽은 데이터를 반대 소켓 메모리에 쓰는 작업이 섞이자, GPU의 KV 복사 속도는 최대 91% 감소했습니다."
카카오 팀은 이를 PCIe 순서 규칙으로 해석했다. 같은 루트 포트를 지나는 읽기 요청은 먼저 들어온 쓰기를 앞지를 수 없어서 소켓 간 링크를 건너느라 늦게 빠지는 쓰기 뒤에 GPU의 요청이 줄을 선다는 것이다. PCIe 수준에서 직접 계측한 결과는 아니고 측정과 맞는 해석이라고 원문은 밝힌다. 소켓마다 KV 전용 NVMe를 두고 각 캐시 서버가 자기 소켓의 디스크를 쓰게 하는 배치는 다음에 검증할 방법으로 남겨 두었고 개선 폭은 아직 측정하지 않았다.
같은 구조의 노드를 쓴다면 배포 전에 확인하라고 원문이 권하는 항목은 다음과 같다.
| 확인할 것 | 방법 | 이유 |
|---|---|---|
| NVMe와 PCIe 경로를 공유하는 GPU | nvidia-smi topo -m, lspci -tv |
노드 종류마다 공유하는 GPU 쌍이 다를 수 있음 |
| 캐시 서버의 소켓 배치 | 서버별 numactl 바인딩과 담당 GPU 대조 |
어긋나도 오류 없이 반대 소켓 메모리를 씀 |
| 서버별 디스크 구성 | 두 서버의 디스크 수·대역폭·용량을 같게 | 재사용 길이가 두 서버 중 짧은 쪽으로 정해짐 |
| 디스크 용도 | KV 전용으로 분리 | 다른 용도와 함께 쓰면 읽기가 흔들림 |
| 운영 지표 | 노드 평균이 아니라 GPU별 복원 속도 | 가장 느린 GPU 쌍이 전체 복원 속도를 정함 |
다른 서빙에 적용한다면
원문은 2.58이라는 배수보다 질문의 순서를 가져가라고 한다. 무엇이 반복되는지, 어디까지 남아 있는지, 다시 가져오는 편이 계산보다 빠른지, 요청이 그곳으로 돌아오는지, 그 선택 때문에 다른 요청이 더 오래 기다리지는 않는지를 차례로 묻는다. EPP 라우팅과 오프로딩을 적용할 수 있는지보다 지금 트래픽에서 어떤 계산이 반복되는지를 먼저 보라는 뜻이다.
- 공통 프리픽스가 짧거나 매번 다른 질문만 들어온다면 줄일 계산이 많지 않다.
- 긴 문서라도 GPU 캐시에 충분히 남아 있다면 외부 계층의 저장 비용이 이득보다 클 수 있다.
- 입력 재계산을 줄인 뒤에도 디코드 단계가 병목으로 남는다면 캐시 용량을 더 늘려도 처리량 개선은 제한적일 수 있다.
외부 캐시를 붙일 때 디스크 읽기 방식의 기본값부터 확인하라는 조언도 있다. 원문이 2026년 9월에 조사한 바로는 Dynamo KVBM, SGLang HiCache의 NIXL 백엔드, vLLM 내장 오프로딩은 O_DIRECT가 기본값이었고 LMCache만 buffered I/O가 기본값이었다.
참고 자료
- 카카오 테크: 같은 GPU로 더 많은 AI 요청을 처리할 수 있을까?
- vLLM Automatic Prefix Caching
- LMCache Multi-Process Mode
- llm-d Prefix Cache Aware Routing
- llm-d: KV-Cache Wins You Can See
- Gateway API Inference Extension
- Envoy AI Gateway