당근마켓 LLM 비용 3배 폭증 원인: 프롬프트 캐시 동작 차이와 해결법
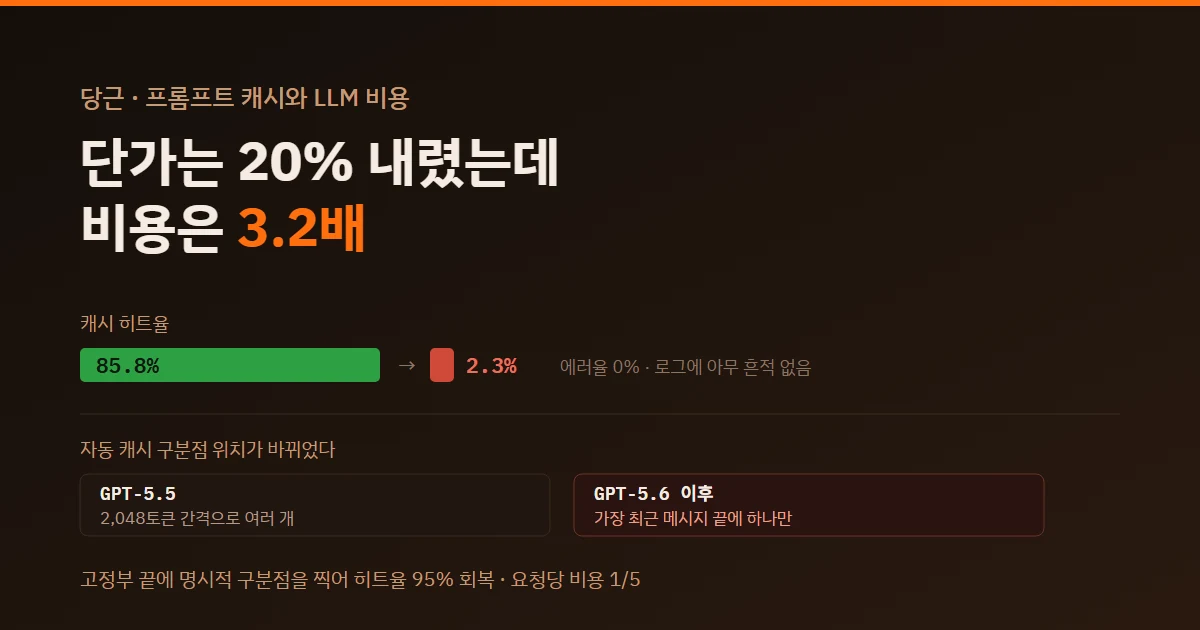
당근마켓 커뮤니티홈팀이 LLM 주제 분류 모델을 Gemini에서 OpenAI GPT-5.6으로 교체한 직후, 단가는 20% 내렸는데 요청당 비용은 3.2배가 뛰었다. 에러 한 줄 없었다. 원인은 프롬프트 캐시 히트율이 85.8%에서 2.3%로 무너진 것. GPT-5.5까지는 2,048토큰 간격 자동 구분점이었으나 GPT-5.6부터는 가장 최근 메시지 끝에만 구분점을 찍는 방식으로 바뀌었기 때문이다. 이 글은 세 제공사(OpenAI, Anthropic, Google)의 캐시 동작 차이를 비교하고, 프로덕션에서 즉시 적용 가능한 명시적 브레이크포인트 설정법과 진단 방법을 정리한다.
(이 글의 초안은 설치된 Hermes 에이전트가 작성했고, Claude가 검수 후 발행했다.)
TL;DR: 모델 교체 시 단가표만 보지 말고 프롬프트 캐시 규칙을 반드시 확인하라. GPT-5.6+는 자동 구분점이 ‘최근 메시지 끝’ 하나로 고정돼 있어 고정 프롬프트+가변 입력이면 캐시가 매번 새로 저장만 된다(쓰기 할증 1.25배). 해결은
prompt_cache_breakpoint로 고정부 끝에 명시적 구분점을 찍고prompt_cache_options.mode: explicit로 자동 구분점 끄기. Anthropic은cache_control: {type: ephemeral}를 system/message 블록에, Gemini는 explicit cachedContent로 선업로드. 캐시 히트율은 토큰 기준으로 하루 이상 운영 트래픽에서 측정해야 한다.
현상: 단가 내렸는데 비용 3배, 에러는 0건
당근마켓은 커뮤니티 피드 글의 주제 분류에 LLM을 사용한다. 요청 구조는 고정된 지시문(카테고리 목록·규칙·예시) + 가변 입력(글 본문) 형태다. 2026년 8월 Gemini에서 GPT-5.6으로 모델을 바꾸자:
- 입력 단가: 20% 인하
- 요청당 실제 비용: 3.2배 증가
- 캐시 히트율: 85.8% → 2.3%
- 에러율: 0%
원문 근거
"교체 전후의 응답을 나란히 놓으면 달라진 곳은 사용량 정보 안의 캐시 필드 하나뿐이었어요. 캐시가 깨져도 에러는 나지 않아요. 비용만 늘어요."
원인은 GPT-5.6부터 자동 캐시 구분점(breakpoint) 위치가 ‘마지막 메시지 끝’ 하나로 변경됐기 때문이다. 기존 2,048토큰 간격 구분점에서는 긴 고정 지시문 안에 여러 구분점이 생겨 고정부가 재사용됐으나, 이제는 ‘지시문+글A’ 전체가 한 덩어리로 저장돼 ‘지시문+글B’와 매칭되지 않는다.
프롬프트 캐시 핵심 원리: KV 캐시의 요청 간 재사용
LLM은 입력 전체를 prefill 단계에서 읽으며 K(Key)와 V(Value) 벡터를 생성해 KV 캐시에 쌓는다. 프롬프트 캐시는 이 KV 캐시의 앞부분을 요청 간에 재사용하는 기능이다.
- 캐시 히트: 앞부분이 구분점 단위로 일치 → prefill 생략, 캐시에서 K/V 로드 (입력 토큰 최대 95% 할인)
- 캐시 미스: 앞부분 불일치 → 전체 prefill 재실행 + 캐시 신규 저장 (쓰기 할증 1.25배 발생 모델에서)
원문 근거
"프롬프트 캐시는 응답 캐시가 아니에요. 응답 캐시는 같은 질문에 저장해 둔 답을 그대로 돌려줘요. 프롬프트 캐시는 입력을 읽는 계산만 재사용하고 출력은 매번 새로 만들어요."
중요: 토큰 하나만 달라도(K에 위치 정보 포함) 그 뒤 K/V는 모두 달라진다. 시각·요청 ID·JSON 키 순서·도구 목록 순서·출력 스키마·reasoning effort 설정 등이 앞부분을 흔든다.
제공사별 캐시 동작 비교표
| 항목 | OpenAI (GPT-5.6+) | Anthropic (Claude Opus 5.5 등) | Google Gemini |
|---|---|---|---|
| 기본 활성화 | 자동 켜짐 | 수동 활성화 (cache_control) |
자동 켜짐 (implicit) |
| 자동 구분점 | 최근 메시지 끝 1개만 | 마지막 블록 끝 1개 (요청 바깥) | 비공개/문서 미명시 |
| 명시적 구분점 | prompt_cache_breakpoint + mode: explicit |
cache_control: {type: ephemeral} 블록 내 (최대 4개) |
explicit cachedContent 선업로드 (별도 저장료) |
| 최소 길이 | 1,024 토큰 | 모델별 상이 (512~4,096) | 2,048~6,144 토큰 |
| 유지 시간 | 30분 (고정, ttl: "30m") |
5분 기본, 1시간 선택 가능 (쓰기 2배) | implicit ~24시간, explicit 60분 기본 |
| 쓰기 할증 | 1.25배 (GPT-5.6+) | 1.25배(5분), 2배(1시간) | implicit 무료, explicit 저장료 별도 |
| 히트 확인 필드 | usage.input_tokens_details.cached_tokens |
usage.cache_read_input_tokens |
usageMetadata.cachedContentTokenCount |
| 진단 기능 | prompt_cache_options.comparison_response_id |
diagnostics 파라미터 |
없음 |
원문 근거
"그런데 GPT-5.6에서 자동 구분점의 위치가 바뀌었어요. GPT-5.5 : 2,048토큰 간격으로 찍어요. GPT-5.6 이후 : 가장 최근 메시지의 끝에 하나 찍어요. GPT-6 계열도 같아요."
OpenAI GPT-5.6+ 해결법: 명시적 브레이크포인트
GPT-5.6 이후 모델에서 고정 프롬프트+가변 입력 패턴을 쓰려면 자동 구분점을 끄고 고정부 끝에 명시적 구분점을 찍어야 한다.
{
  "model": "gpt-6.1-sol",
  "prompt_cache_options": { "mode": "explicit" },
  "input": [
    {
      "role": "developer",
      "content": [
        {
          "type": "input_text",
          "text": "(매번 같은 지시문, 규칙, 예시)",
          "prompt_cache_breakpoint": { "mode": "explicit" }
        }
      ]
    },
    { "role": "user", "content": "(요청마다 바뀌는 입력)" }
  ]
}
prompt_cache_options.mode: explicit→ 자동 구분점 비활성화 (매번 바뀌는 입력에 쓰기 할증 방지)prompt_cache_breakpoint붙은 블록까지가 한 덩어리로 저장 → 입력이 바뀌어도 지시문 덩어리 재사용- 요청당 최대 4개 캐시 쓰기 가능
당근마켓은 사내 LLM 플랫폼 템플릿 첫 변수 앞에 구분점을 찍도록 수정해 히트율 95% 회복, 요청당 비용 약 1/5로 감소.
원문 근거
"고친 뒤 주제 분류의 히트율은 95% 안팎으로 올랐고, 요청당 비용은 약 5분의 1로 줄었어요."
Anthropic: cache_control 블록 내 직접 지정
Anthropic은 캐시가 기본 비활성화라 요청에 cache_control을 붙여야 한다. 고정 지시문+가변 입력 패턴에서는 system 블록 끝에 찍는 것이 정석이다.
{
  "model": "claude-opus-5-5",
  "max_tokens": 1024,
  "system": [
    {
      "type": "text",
      "text": "(매번 같은 지시문, 규칙, 예시)",
      "cache_control": { "type": "ephemeral" }
    }
  ],
  "messages": [
    { "role": "user", "content": "(요청마다 바뀌는 입력)" }
  ]
}
- 앞부분 구성 순서: 도구 정의 → 시스템 프롬프트 → 메시지. system 끝에 찍으면 도구 정의+지시문 함께 저장
ttl: "1h"로 1시간 연장 가능 (쓰기 할증 2배, 요청 간격 5분~1시간 사이일 때만 유리)- 진단:
diagnostics파라미터로tools_changed등 미스 사유 확인 가능
Gemini: implicit는 편하나 보장 없고, explicit은 저장료 별도
Gemini implicit 캐시는 기본 켜짐이나 “캐시에서 읽었을 때”만 할인이라고 문서에 명시돼 읽힘 보장 없다. 구분점 위치 제어 불가.
# 1) 고정부 미리 올리기 (cachedContent 생성)
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/cachedContents
{
  "model": "projects/PROJECT_ID/locations/LOCATION/publishers/google/models/gemini-3.5-flash",
  "contents": [{ "role": "user", "parts": [{ "text": "(매번 같은 지시문, 규칙, 예시)" }] }],
  "ttl": "3600s"
}

# 2) 요청에서는 캐시 이름만 부르기
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/gemini-3.5-flash:generateContent
{
  "cachedContent": "projects/PROJECT_NUMBER/locations/LOCATION/cachedContents/CACHE_ID",
  "contents": [{ "role": "user", "parts": [{ "text": "(요청마다 바뀌는 입력)" }] }]
}
- explicit cachedContent는 할인 보장(ensures)하나 저장 시간만큼 저장료 별도 부과
- Gemini 4부터 explicit 캐시 지원 중단 (API 문서·지원 모델 목록에서 제외)
캐시 히트율 확인과 진단 체크리스트
응답의 캐시 필드로 토큰 기준 히트율을 측정해야 한다(요청 기준은 후하게 나옴).
// OpenAI Responses API
"usage": {
  "input_tokens": 5000,
  "input_tokens_details": {
    "cached_tokens": 4800,           // 캐시에서 읽음
    "cache_write_tokens": 0          // 새로 저장 (쓰기 할증)
  }
}

// Anthropic
"usage": {
  "input_tokens": 200,
  "cache_read_input_tokens": 4800,   // 캐시에서 읽음
  "cache_creation_input_tokens": 0   // 새로 저장 (쓰기 할증)
}

// Gemini
"usageMetadata": {
  "promptTokenCount": 5000,
  "cachedContentTokenCount": 4800
}
진단 순서 (캐시 의심 시 위부터 순차 확인):
- 고정부 길이 ≥ 모델 최소 길이? (OpenAI 1,024, Anthropic 모델별 512~4,096, Gemini 2,048~6,144)
- 고정부 앞부분이 글자 하나까지 동일한가? (시각·UUID·JSON 키 순서·도구 순서·출력 스키마·reasoning 설정 제거/맨 뒤로 이동)
- 유지 시간 내에 같은 앞부분이 재요청되는가? (OpenAI 30분, Anthropic 5분/1시간, Gemini ~24시간)
- 명시적 구분점이 고정부와 가변부 경계에 정확히 찍혔는가? (SDK/게이트웨이가 구분점 누락하지 않는지 확인)
- 진단 API로 미스 사유 확인 (OpenAI
comparison_response_id, Anthropicdiagnostics)
원문 근거
"캐시가 의심되면 위에서부터 차례로 확인하고 해당하는 단계에서 오른쪽에 적은 대로 고쳐요."
비용 모델: 히트율 h일 때 평균 배율
쓰기 할증 1.25배 모델에서 고정부 토큰 기준 평균 비용 배율:
0.1 × h + 1.25 × (1 − h)
h ≈ 22% 미만이면 캐시 없는 것보다 비싸진다(읽기 0.05배 모델도 ≈ 21%). 당근마켓 사례는 h=2.3% → 1.22배로 캐시 없음(1.0)보다 비쌌다.
운영 지표로 모델 교체 검증하기
모델 교체는 코드 한 줄 변경이 아니라 운영 조건 변경이다. 배포 전후로 다음 지표를 운영 트래픽에서 하루 이상 측정해야 한다:
- 요청당 입력 비용 (단가 × 토큰 × 캐시 배율)
- 응답 지연 시간 (p50/p99)
- 토큰 기준 캐시 히트율 (사용자/날짜 단위 집계)
- 캐시 쓰기 토큰 수 (쓰기 할증 발생량)
원문 근거
"응답이 맞게 나오는지에 더해 요청당 비용, 응답 시간, 캐시 히트율을 교체 전과 나란히 비교하세요. 이 비교는 몇 건으로는 할 수 없어요. 캐시는 앞선 요청이 데워 둬야 읽히고 요청이 얼마나 자주 오느냐에 따라 달라져서, 몇 건만 보내 보면 실제와 다른 숫자가 나와요."
당근마켓도 배포 다음 날 히트율만 봤다면 닷새가 아니라 하루 만에 알아챘을 것이다. 지금은 구분점을 플랫폼이 자동으로 찍게 하고, 개발자는 “바뀌는 부분은 템플릿 끝에 둔다” 규칙만 지키게 했다.
참고 자료 (공식 문서, 2026년 10월 기준)
- OpenAI: Prompt caching / Prompt cache diagnostics
- Anthropic: Prompt caching / Cache diagnostics
- Google: Context caching overview / Gemini API context caching
캐시 규칙은 모델 버전마다 바뀌니 적용 전 최신 문서로 재확인 필요.