Salesforce SOV-Transcribe-1: 지시문과 키워드로 제어하는 4B 오픈 가중치 ASR, vLLM으로 서빙하기
Salesforce Sovereign Intelligence 팀이 11월 12일 음성 인식 모델 SOV-Transcribe-1을 Hugging Face에 Apache 2.0 라이선스로 올렸다. 활성 파라미터 4B(전체 26B)짜리 비스트리밍 ASR 모델이다. 전사 형식은 자연어 지시문으로 바꾸고 잘 틀리는 고유명사는 키워드 목록을 넘겨 보정한다. 모델 카드에 vLLM 플러그인과 Transformers 예제가 들어 있어서 녹음 파일 전사 파이프라인에 오늘 붙여 볼 수 있다. (이 글의 초안은 설치된 Hermes 에이전트가 작성했고, Claude가 검수 후 발행했다.)
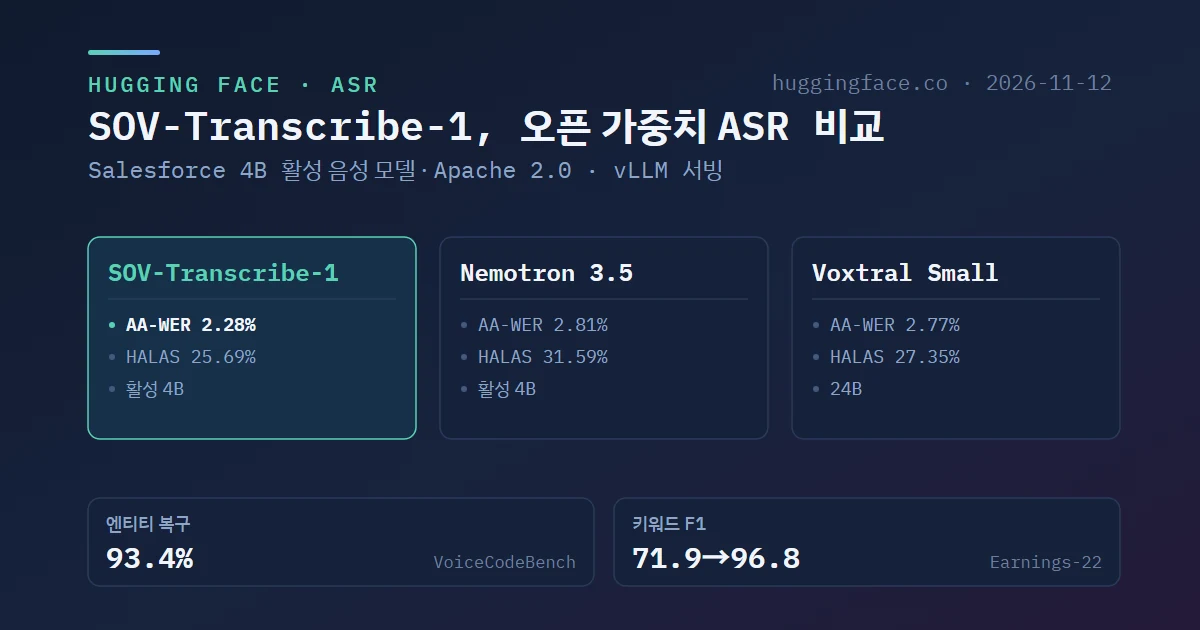
TL;DR: SOV-Transcribe-1은 Whisper large-v3 인코더에 Gemma 4 26B A4B를 붙인 오픈 가중치 ASR 모델이다. Artificial Analysis 비스트리밍 음성 인식에서 WER 2.28%로 오픈 가중치 1위(전체 7위), VoiceCodeBench에서 엔티티 복구율 93.4%로 오픈 가중치 1위(23개 시스템 중 2위)다. 지시문을 주면 전사 형식이 바뀌고 키워드를 주면 Contextual Earnings-22의 키워드 F1이 71.9에서 96.8로 오른다. 지금은 저장소에 든 vLLM 플러그인(vLLM 0.32.0)이나
trust_remote_codeTransformers로 돌린다. 지원 언어는 7개이고 실시간 스트리밍용은 아니다.
모델 개요와 접근 경로
원문 블로그는 이 모델을 음성 증강 언어 모델(speech-augmented language model)이라고 부르고 활성 파라미터 4B에 전체 26B라고 적었다. 모델 카드는 조금 더 자세하다. Whisper large-v3 오디오 인코더와 오디오 프로젝터, Gemma 4 26B A4B MoE를 이은 구조이고 오디오 인코더까지 합친 파라미터는 전체 26.6B에 활성 4.6B다.
모델 카드에서 운영에 필요한 사양만 추렸다.
| 항목 | 내용 |
|---|---|
| 모델 ID | salesforce-sovereign-intelligence/SOV-Transcribe-1 |
| 라이선스 | Apache 2.0 |
| 정밀도 | BF16 (MoE 라우터는 FP32) |
| 입력 | 16 kHz 오디오, 선택적으로 텍스트 지시문과 컨텍스트 |
| 최대 오디오 길이 | 30분까지 테스트됨 |
| 언어 | 영어, 프랑스어, 독일어, 스페인어, 이탈리아어, 포르투갈어, 네덜란드어 |
| 추론 프레임워크 | vLLM, Hugging Face Transformers |
| 추측 디코딩 | 별도 저장소의 DFlash 드래프트 모델 salesforce-sovereign-intelligence/SOV-Transcribe-1-DFlash |
한국어는 지원 언어에 없다. 비스트리밍 모델이라 통화 중에 실시간으로 받아 적는 용도에도 맞지 않는다. 영어권 콜센터 녹음, 실적 발표, 회의 녹음처럼 끝난 오디오를 후처리하는 자리에 쓴다. 같은 4B 활성 파라미터급으로 40개 언어를 다루는 모델이 필요하면 NVIDIA Nemotron 3.5 Transcribe와 견줘 보면 된다.
벤치마크 결과
원문이 본문에서 수치를 밝힌 벤치마크는 여섯 개다. 순위는 원문 기준 2026년 11월 12일 시점이다.
| 벤치마크 | 지표 | SOV-Transcribe-1 | 원문이 함께 든 비교 |
|---|---|---|---|
| Artificial Analysis (비스트리밍) | AA-WER | 2.28% | Nemotron 3.5 Transcribe 2.81%, Voxtral Small 2.77%. 오픈 가중치 1위, 전체 7위 |
| VoiceCodeBench | 통과율 / 엔티티 복구율 | 76.3% / 93.4% | 두 지표 모두 오픈 가중치 1위, 23개 시스템 중 2위 |
| AppTek Call-Center Dialogues | 평균 WER | 8.21% | 영어 억양 14개 중 8개(호주, 영국, 스코틀랜드, 웨일스, 아일랜드, 인도, 멕시코, 싱가포르)에서 최저 |
| HALAS (실적 발표 실음성) | WER | 25.69% | Qwen3-ASR 1.7B 26.01%, Voxtral Small 24B 27.35%, Nemotron 3.5 Transcribe 31.59%, Granite Speech 5.0 2B 34.51% |
| Preference-ASR (지시문 제공) | 선호 반영 WER | 5.05% | Granite Speech 5.0 2B 4.70%, Qwen3-ASR 1.7B 5.96%, Nemotron 3.5 Transcribe 6.16% |
| Contextual Earnings-22 | 키워드 F1 | 71.9 → 96.8 | 통화 전체 키워드 목록을 줘도 94.0 |
AA-WER에서는 활성 파라미터 수가 같은 Nemotron 3.5 Transcribe와, 24B인 Voxtral Small을 모두 앞섰다. 원문은 비슷한 크기의 다른 오픈 가중치 모델이 4% 안팎이라고 덧붙였다.
원문 근거
"At 2.28% WER, it beats NVIDIA's Nemotron 3.5 Transcribe (2.81%) with the same number of active parameters, and Mistral's Voxtral Small (2.77%) with 6x fewer (4B vs. 24B)."
HALAS는 모델이 환각을 일으키기 쉬운 실적 발표 음성을 사람이 주석한 벤치마크다. 25.69%는 오픈 가중치 모델 중에서 가장 낮은 값일 뿐, 절대 수치로는 여전히 높다. 잡음 섞인 실제 음성에서는 결과를 그대로 믿지 말고 검수 단계를 둬야 한다는 뜻으로 읽는 편이 맞다.
원문 근거
"SOV-Transcribe-1 achieves a 25.69% word error rate, lower than all other open-weight models, including Alibaba's Qwen3-ASR 1.7B (26.01%), Mistral's Voxtral Small 24B (27.35%), NVIDIA's Nemotron 3.5 Transcribe (31.59%), and IBM's Granite Speech 5.0 2B (34.51%)."
모든 항목에서 1위는 아니다. 지시문을 따르는 정도를 재는 Preference-ASR에서는 IBM Granite Speech 5.0 2B가 앞선다.
원문 근거
"With instructions, SOV-Transcribe-1 achieves a 5.05% preference-aware word error rate, second only to IBM's Granite Speech 5.0 2B (4.70%) and ahead of Alibaba's Qwen3-ASR 1.7B (5.96%) and NVIDIA's Nemotron 3.5 Transcribe (6.16%)."
파이프라인에서 쓰는 두 기능
지시문으로 전사 형식 바꾸기
기본 동작은 들리는 대로 받아 적는 것이다. 숫자를 아라비아 숫자로 쓰게 하거나 말더듬과 군말을 빼게 하려면 사용자 메시지에 지시문을 넣는다. 원문은 법정 증언 녹취와 받아쓰기 메시지를 예로 든다. 증언 녹취는 군말까지 한 단어도 빼지 않아야 하고 받아쓰기 메시지는 깔끔하게 다듬은 글이어야 한다.
모델 카드의 프롬프트 가이드는 아래 문구를 권한다.
| 목적 | 사용자 메시지 |
|---|---|
| 들리는 대로 전사 | Transcribe the audio verbatim, outputting only spoken words in sequence. |
| 키워드 제공 | This audio may contain the following words or phrases: {keywords}. Transcribe the audio into text. |
| 언어 자동 판별 | Transcribe the audio verbatim in the language's standard writing system, using punctuation and capitalization. Output only the transcript. |
| 언어 지정 | Transcribe the {language} audio into text, ensuring all punctuation marks are included. |
키워드로 고유명사 보정하기
고객 이름, 약 이름, 제품명은 드물게 나오거나 다른 단어와 소리가 비슷해서 자주 틀린다. 위 표의 키워드 문구에 쉼표로 구분한 용어 목록을 넣거나, 오디오가 무엇에 관한 것인지 짧게 설명해 주면 모델이 그쪽으로 맞춰 적는다.
Contextual Earnings-22는 실적 발표에서 잘라 낸 15초 클립으로 이 기능을 잰다. 클립에 실제로 나오는 키워드만 줬을 때와, 한 시간짜리 통화 전체의 키워드를 다 줬을 때를 따로 측정한다. 후자는 목록 대부분이 그 클립에 나오지 않는 방해 항목이다.
원문 근거
"Given just the clip's keywords, SOV-Transcribe-1 raises its keyword F1, a measure of how accurately those names are transcribed, from 71.9 to 96.8. Given the full list, it still scores 94.0, the highest of the open-weight models."
방해 항목이 섞여도 94.0이 나온다. 그러니 통화마다 키워드를 정교하게 고르지 않고 고객사 용어집을 통째로 넘기는 방식도 시도해 볼 만하다. 다만 모델 카드는 컨텍스트를 관련 있는 이름과 용어, 짧은 도메인 설명 정도로 좁히라고 권한다.
설치와 서빙
블로그 원문에는 실행 코드가 없고 기술 리포트는 “coming soon”이다. 사용법은 모델 카드에 있다. vLLM과 Transformers의 네이티브 지원은 업스트림에 올리는 중이라 그 전까지는 저장소에 든 vLLM 플러그인과 모델링 코드를 쓴다.
원문 근거
"Native support in vLLM and Hugging Face Transformers is being upstreamed. Until it is released, a vLLM plugin adds native support to vLLM 0.32.0, and this repository ships its modeling code for Transformers."
설치는 두 갈래다.
# Transformers
pip install "transformers>=5.19,<5.23" torch librosa accelerate

# vLLM: 저장소의 vllm_plugin/ 폴더를 받아 설치한다 (vLLM 0.32.0이 함께 설치된다)
hf download salesforce-sovereign-intelligence/SOV-Transcribe-1 --include "vllm_plugin/*" --local-dir SOV-Transcribe-1
pip install ./SOV-Transcribe-1/vllm_plugin
모델 카드가 권장하는 쪽은 vLLM이다. 플러그인을 설치하면 OpenAI 호환 전사 엔드포인트로 띄울 수 있다.
vllm serve salesforce-sovereign-intelligence/SOV-Transcribe-1 --max-model-len 32768
curl http://localhost:8000/v1/audio/transcriptions -F model=salesforce-sovereign-intelligence/SOV-Transcribe-1 -F file=@meeting.wav -F temperature=0
이 엔드포인트는 기본으로 들리는 대로 전사하는 지시문을 쓴다. 다른 지시문은 -F prompt="..."로 넘긴다. 요청 하나가 받는 오디오는 600초까지이고 30분짜리를 넣으려면 환경 변수 VLLM_MAX_AUDIO_DECODE_DURATION_S를 1800으로 올려야 한다.
Transformers로 쓸 때는 AutoProcessor와 AutoModelForMultimodalLM을 trust_remote_code=True로 불러온다. 저장소의 커스텀 코드를 실행한다는 뜻이니, 원격 코드를 막아 둔 환경이라면 모델 카드에 실린 자체 완결형 함수를 복사해 쓰는 길이 있다.
운영할 때 챙길 설정도 모델 카드에 나와 있다.
- 디코딩은 그리디로 한다. vLLM에서는
temperature=0,top_p=1.0,top_k=0,repetition_penalty=1.0, Transformers에서는do_sample=False다. - 오디오는 16 kHz 모노로 준비한다. 지시문은 사용자 메시지에 넣고 thinking은 끈다.
- 긴 녹음은 필요하면 발화 경계에서 잘라 순서대로 이어 붙인다. 출력이 잘렸거나 반복되지 않는지 확인한다.
- 드물게 한 글자나 구절을 토큰 한도까지 반복하는 경우가 있다. 모델 카드는 Qwen3-ASR 툴킷에서 가져온 후처리로 이 반복을 지운다고 밝혔다.
DFlash 추측 디코딩
DFlash 드래프트 모델을 붙이면 드래프트가 한 번에 15토큰씩 제안하고 본 모델이 검증한다. 모델 카드에 따르면 요청을 하나씩 처리할 때 디코딩이 2~3배쯤 빨라지고(10초 미만 클립은 효과가 작다) 정확도는 드래프트 없이 돌렸을 때의 실행 간 편차 범위 안이다.
vllm serve salesforce-sovereign-intelligence/SOV-Transcribe-1 --max-model-len 32768 --max-num-seqs 64 \
  --speculative-config '{"method": "dflash", "model": "salesforce-sovereign-intelligence/SOV-Transcribe-1-DFlash", "num_speculative_tokens": 15}'
--max-num-seqs 64는 빼면 안 된다. vLLM 기본값인 동시 시퀀스 1,024개로는 드래프트를 올렸을 때 96 GB GPU에서도 메모리가 모자란다.
원문 근거
"`max_num_seqs=64` keeps vLLM's start-up memory profiling within a 96 GB GPU; vLLM's default of 1,024 concurrent sequences runs out of memory with the draft."
아래는 모델 카드가 NVIDIA RTX PRO 6000 Blackwell(96 GB) 한 장에서 요청을 하나씩 보내 잰 평균 처리 시간이다. vLLM 0.32.0, BF16, 그리디 디코딩 조건이다.
| 오디오 길이 | 드래프트 없음 | 드래프트 사용 |
|---|---|---|
| 10초 이하 | 0.16초 | 0.09초 |
| 10~30초 | 0.44초 | 0.15초 |
| 30~60초 | 0.88초 | 0.31초 |
| 1~5분 | 2.78초 | 1.26초 |
측정 장비가 96 GB GPU 한 종류뿐이고 더 작은 GPU의 최소 요구 사양은 모델 카드에 없다. 24 GB급 카드에 올릴 계획이라면 직접 띄워서 확인해야 한다.
도입 전에 따져 볼 것
- 언어: 7개 유럽어만 지원한다. 한국어 음성에는 쓸 수 없다.
- 스트리밍: 비스트리밍 전용이다. 실시간 음성 에이전트의 입력단이 아니라 녹음 후처리에 맞다.
- 통합 성숙도: 네이티브 지원이 업스트림되기 전이라 vLLM 버전이 0.32.0에 묶이고 Transformers는 원격 코드 실행이 필요하다.
- 근거 자료: 벤치마크 수치는 제공사가 발표한 것이고 기술 리포트는 아직 나오지 않았다. Open ASR과 ContextASR-Bench 결과는 원문에 표 이미지로만 실려 있어 이 글에는 옮기지 않았다.
참고
- 원문: Introducing Salesforce SOV-Transcribe-1: #1 Open-Weight Model Built for Real-World Speech (2026-11-12)
- 모델 카드: salesforce-sovereign-intelligence/SOV-Transcribe-1 · DFlash 드래프트
- Artificial Analysis 리더보드: non-streaming speech-to-text
- VoiceCodeBench: BeSimple 리더보드
- AppTek Call-Center Dialogues: arXiv:2604.27543
- HALAS: arXiv:2606.23048
- Preference-ASR: arXiv:2606.29534
- Contextual Earnings-22: arXiv:2604.07354