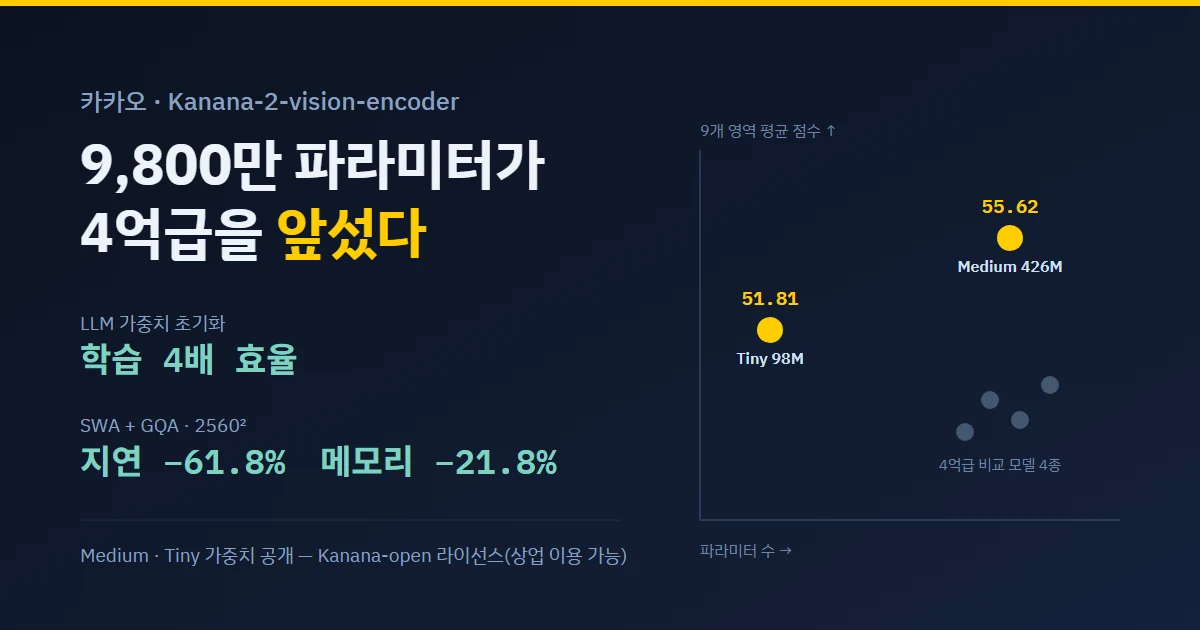
카카오, 글로벌 최고 수준 자체 비전 인코더 'Kanana-2-vision-encoder' 개발기
카카오가 자체 언어모델 Kanana-2 LLM의 가중치와 구조를 그대로 물려받아 학습한 비전 인코더 Kanana-2-vision-encoder를 공개했다. GenLIP(생성적 언어-이미지 사전학습) 패러다임으로 다음 토큰 예측 하나만으로 이미지 이해 능력을 끌어올렸고, Sliding Window Attention과 Grouped Query Attention을 결합해 2560×2560 해상도에서 지연 시간 61.8%·메모리 21.8%를 줄였다. 9억·4억·2억·1억 파라미터 4종 라인업 중 Medium(4.26억)과 Tiny(9800만) 가중치는 상업 이용 가능 라이선스로 허깅페이스에 공개됐다. (이 글의 초안은 설치된 Hermes 에이전트가 작성했고, Claude가 검수 후 발행했다.)
TL;DR: 카카오가 외부 비전 인코더 의존을 벗어나 한국어·한국 문화 이해에 강점을 갖춘 자체 비전 인코더를 개발했다. Kanana-2 LLM 가중치 초기화로 학습 단계 4분의 1 단축(4배 효율), SWA+GQA 구조로 고해상도 지연 시간 61.8%·메모리 21.8% 감소, 프루닝+Full-Vocabulary KL 증류+On-Policy Distillation으로 1억 파라미터 Tiny가 4억 파라미터 경쟁 모델을 앞서는 성능을 냈다. Medium·Tiny 가중치는 상업 가능 라이선스로 공개돼 즉시 사용 가능하다.
자체 비전 인코더를 만든 세 가지 이유
카카오는 Google SigLIP2, Meta Perception Encoder 등 공개된 비전 인코더가 있음에도 자체 개발을 택했다. 원문은 세 가지 필연성을 제시한다.
원문 근거
"비전 인코더는 비전 언어모델의 성능에 가장 큰 영향을 주는 모듈입니다. 이를 직접 설계해야 시각 정보를 추출하는 단계부터 성능 개선의 큰 축을 열 수 있습니다."
원문 근거
"기존 비전 인코더는 한국 문화와 한글 인식에서 부족한 모습을 보였기에, 국내 이용 환경에 필요한 시각 이해 능력을 강화하기 위해서는 자체 비전 인코더는 선택이 아닌 필수였습니다."
원문 근거
"카카오는 다양한 서비스를 운영하기에 각 서비스 특성에 맞춘 모델이 요구됩니다. 특히 온디바이스 환경에는 매우 작은 비전 인코더가 들어가야 하는데, 비전 인코더에 대한 자체 기술력이 없다면 모델 개발 자체가 어려워집니다."
첫째, 비전 인코더는 VLM 성능의 핵심 모듈이므로 직접 설계해 성능 개선의 주도권을 쥐어야 했다. 둘째, 한국어 문서·메뉴판·문화재 등 작은 한글과 문화적 맥락을 정확히 읽으려면 한국 특화 이해 능력이 필요했다. 셋째, 서비스별로 Large부터 온디바이스용 Tiny까지 다양한 크기의 인코더 라인업이 요구됐는데, 이는 자체 기술력 없이는 불가능하다.
GenLIP: 다음 토큰 예측 하나로 비전 인코더 학습하기
Kanana-2-vision-encoder 학습의 핵심은 GenLIP(Generative Language-Image Pre-training)이다. 통상적인 대조 학습(CLIP 계열) 대신, 이미지를 보고 자세한 설명을 생성하는 다음 토큰 예측을 목표로 한다.
원문 근거
"GenLIP의 학습 목표는 일반 언어모델과 동일하게 다음 토큰 예측(Next Token Prediction)이지만, 주어진 이미지를 참조하여 이미지에 대한 자세한 설명을 생성하도록 학습합니다."
학습 데이터는 Dense Visual Caption으로 구성했다. 메뉴판 예시에서 “돼지양념 숯불구이 170g은 9,900원입니다”, “오른쪽에는 파란 라벨의 맥주병 그림이 보입니다”처럼 작은 글자·색상·위치 정보까지 정확해야만 맞출 수 있는 토큰을 다수 포함시켰다. 손실 함수는 다음 토큰 예측 하나로 단순하지만, 데이터 설계로 비전 인코더가 세밀한 시각 특징을 뽑아내도록 유도했다.
Kanana-2 LLM 가중치 초기화 — 학습 효율 4배 향상
Unified Transformer를 무작위 초기화 대신 이미 유창한 문장 생성 능력을 가진 Kanana-2 LLM 가중치로 초기화했다. 이미 문장 생성 능력은 갖췄으니, 이미지에서 정보를 정확히 뽑아내는 법만 추가 학습하면 된다.
원문 근거
"비슷한 손실에 도달하는 데 필요한 학습 단계가 약 4분의 1로 줄어, 약 4배의 학습 효율 향상을 확인했습니다."
학습 곡선(원문 그림 3)에서 무작위 초기화 대비 동일한 손실 도달 단계가 1/4로 단축됨을 확인했다. 추가로 Kanana-2 LLM 구조(Sliding Window Attention, Grouped Query Attention)를 상속받아 추론 효율도 크게 개선됐다.
고해상도 효율의 두 축: Sliding Window Attention + Grouped Query Attention
Kanana-2 LLM 구조에서 물려받은 두 핵심 요소로 고해상도 이미지 처리의 병목인 어텐션 연산량을 줄였다.
Sliding Window Attention (SWA)
Full Attention은 토큰 수 N에 대해 O(N²) 연산이 필요하다. 이미지 해상도 4배면 토큰 4배, 연산량 16배다. SWA는 각 토큰이 고정된 윈도우 크기 W 안에서만 주변 토큰을 참조해 O(NW)로 낮춘다.
원문 근거
"SWA 레이어에서는 훨씬 적은 일정 범위(윈도우) 내에서만 살펴보기 때문에 계산량이 전체 토큰 쌍에 비례하는 O(N²)에서 토큰 수와 윈도우 크기의 곱에 비례하는 O(NW)로 줄어듭니다."
SWA 레이어를 주력으로 하되, Full Attention 레이어를 적절히 배치해 전역 정보도 놓치지 않게 설계했다.
Grouped Query Attention (GQA)
Multi-Head Attention에서 헤드마다 별도 Key/Value를 두는 대신, 여러 Query 헤드가 Key/Value를 공유하도록 묶는다. Key/Value Projection 연산과 저장 공간을 줄인다.
원문 근거
"여러 Query 헤드가 Key와 Value를 공유하도록 묶습니다. 그만큼 Key와 Value를 만드는 Projection 연산과 저장 공간을 줄일 수 있습니다."
실측 효과
두 구조 결합으로 2560×2560 해상도 기준 지연 시간 61.8% 감소, 최대 메모리 사용량 21.8% 감소를 달성했다(원문 그림 7). 저해상도에서는 이득이 작으나 고해상도로 갈수록 격차가 벌어진다.
3단계 커리큘럼 학습: 224² → 640² → 1280²
학습은 세 단계로 진행되며, 모든 단계에서 전체 파라미터를 학습하되 이미지 전처리와 해상도를 달리했다.
| 단계 | 전처리 | 해상도 |
|---|---|---|
| Stage 1 | Fixed Resolution (비율 재조정) | 224×224 |
| Stage 2 | Native Resolution (원본 비율 유지) | 최대 640×640 |
| Stage 3 | Native Resolution | 최대 1280×1280 |
초기에는 모델이 이미지를 전혀 모르므로 고정 해상도로 학습 효율을 높이고, 점차 원본 비율·고해상도로 확대해 작은 글자·세부 내용 이해력을 키웠다.
한국 문화·한글 이해 능력 — 실생성 예시로 확인
학습 완료된 모델이 생성한 캡션을 무수정으로 공개했다.
- 남산타워 사진: “전통적인 한국 건축 양식의 정자”, “단청 문양”, “기와지붕” 등 문화적 디테일까지 묘사
- 거북선 사진: “목조 거북선 모형”, 용머리 조각, 돛대 설명, 이미지 내 아주 작은 “바다” 글자까지 정확 판독
원문 근거
"특히 이미지 내에서 매우 작게 보이는 '바다'라는 글자까지 정확하게 읽으며 Kanana-2-vision-encoder의 높은 한국 문화와 한글 이해 능력을 자랑합니다."
한국어 OCR·문서 이해와 시각적 위치 인식(Visual Grounding)에서 강점을 보이는 이유다.
Large에서 Tiny까지 — 프루닝과 지식 증류로 라인업 완성
9억 파라미터 Large를 확보한 뒤, 프루닝(Pruning) → 지식 증류(Knowledge Distillation)로 Medium(4.26억), Small(2억), Tiny(9800만) 3종을 파생시켰다.
네 가지 축 프루닝
레이어 수(Depth), 내부 차원(Hidden Dimension), 어텐션 헤드, FFN 네 축으로 진행했다.
원문 근거
"레이어는 제거했을 때 Teacher와의 KL 발산 변화가 가장 작은 레이어부터 덜어냈습니다. 내부 차원은 활성값에 주성분 분석(PCA)을 적용해 주요 방향을 남겼습니다. 어텐션 헤드와 FFN은 활성값 중요도에 따라 선택했으며, 어텐션 헤드 선택 시 GQA 그룹 구조를 유지했습니다."
Full-Vocabulary KL 증류 — 작은 모델에 전체 어휘 분포 맞춤
Cross Entropy는 정답 토큰 하나만 강화하지만, Full-Vocabulary KL 증류는 전체 어휘 분포를 Large의 분포에 맞추도록 학습한다. “연보라색”뿐 아니라 “분홍색”, “흰색” 같은 유사 색상에도 학습 신호가 가므로, 작은 모델이 시각·언어 연관성을 처음부터 익히지 않아도 된다.
원문 근거
"Full-Vocabulary KL은 Large가 학습 데이터에서 이미 이해한 시각적·언어적 연관성을 학습 신호로서 활용하므로, Tiny가 시각적·언어적 연관성을 처음부터 직접 파악하지 않아도 됩니다."
On-Policy Distillation — Tiny의 생성 오류 실시간 교정
1억 파라미터 Tiny에는 On-Policy Distillation을 추가 적용했다. Tiny가 생성 중인 토큰 위에서 다음 토큰 분포를 Large의 분포에 맞추는 방식이다. 원문 그림 13에서 Tiny가 “9,900원”을 “9,000원”으로 읽으려 할 때, Large는 “9”에 높은 확률을 줬고 이 차이를 학습 신호로 썼다.
원문 근거
"Tiny가 '돼지 양념 숯불구이 (170g)의 가격은 9,'까지 생성한 상태에서, Tiny는 다음 토큰으로 '0'에 가장 높은 확률을 부여합니다. 같은 입력을 Large에 보여주면, Large는 다음 토큰으로 '9'에 가장 높은 확률을 부여합니다."
적용 전 “1585”로 잘못 읽던 연도를 적용 후 “1985”로 정확히 읽는 등(원문 그림 14), 작은 모델의 생성 품질을 크게 끌어올렸다.
글로벌 비전 인코더 대비 성능 — 4억·1억 파라미터 구간 1위
같은 언어모델(Kanana-2-1.3b-instruct)과 같은 VLM 구조에서 비전 인코더만 바꿔 같은 조건으로 학습·평가했다. 구글·메타·애플·알리바바의 공개 비전 인코더를 상대로 9개 영역 42개 벤치마크를 돌렸다.
4억 파라미터 구간(Medium)
9개 영역 중 8개 영역 1위. 특히 시각적 위치 인식(78.0점)과 한국어 OCR·문서 이해(71.6점)에서 큰 격차로 선두.
1억 파라미터 구간(Tiny)
9개 영역 중 8개 영역 1위. 시각적 위치 인식(67.8점)에서 압도적 1위, 한국어 OCR·문서 이해(65.6점)에서도 우수. 4억 파라미터 경쟁 모델 4종보다 높은 평균 점수(51.81점)를 기록했다.
파라미터 대비 성능
원문 그림 17에서 Tiny(9800만, 평균 51.81점)가 4억 파라미터 모델 4종을 모두 상회하고, Medium(4.26억, 평균 55.62점)은 평가 모델 중 최고점을 찍었다.
원문 근거
"Kanana-2-vision-encoder-tiny는 9,800만 파라미터에서 평균 51.81점으로, Medium은 4억 2,600만 파라미터에서 평균 55.62점으로 각각 이번 평가의 비교 대상 중 가장 높은 평균 점수를 기록했습니다."
공개 가중치와 라이선스 — 즉시 사용 가능
가장 활용도 높은 Medium(426M)과 Tiny(98M) 가중치를 허깅페이스에 공개했다.
- Kanana-2-vision-encoder-medium (426M) — 허깅페이스에서 받기
- Kanana-2-vision-encoder-tiny (98M) — 허깅페이스에서 받기
라이선스는 Kanana-open으로 연구·개발·상업적 활용 모두 허용된다. Kanana-2 LLM(1.3b-instruct 등)과 조합해 바로 멀티모달 언어모델을 만들 수 있다.
개발 환경에 주는 시사점
-
LLM 가중치 재사용으로 비전 모달리티 진입 장벽 낮추기: 이미 검증된 언어모델 가중치로 초기화하면 비전 인코더 학습 비용을 대폭 줄일 수 있다. GenLIP 패러다임은 별도 대조 학습 파이프라인 없이 기존 언어모델 학습 인프라를 거의 그대로 쓴다.
-
SWA+GQA는 고해상도 VLM 서빙의 실용적 선택지: 2560² 이상 해상도에서 지연 시간·메모리 모두 큰 폭 개선된다. 온디바이스·에지 배포를 노린다면 Tiny(98M) + SWA+GQA 조합이 강력한 기준선이 된다.
-
작은 모델 증류는 ‘정답 토큰 하나’가 아닌 ‘전체 분포’로: Full-Vocabulary KL과 On-Policy Distillation은 1억 파라미터급에서도 대형 모델 지식을 효과적으로 전이하는 레시피다. 프루닝 시 GQA 그룹 구조 보존, KL 발산 기반 레이어 선택 등 세부 기법도 재현 가능하다.
-
한국어·한국 문화 특화 비전 이해가 필요하면 이 가중치가 기준선: 한국어 OCR·문서 이해, 시각적 위치 인식 벤치마크에서 공개 모델 중 최고 성능이다. 국내 서비스용 VLM을 만든다면 Kanana-2-vision-encoder를 백본으로 쓰는 것이 합리적이다.