DaisyRose-27B: Qwen3.8-27B을 강화학습만으로 후처리해 터미널 벤치마크를 두 배로
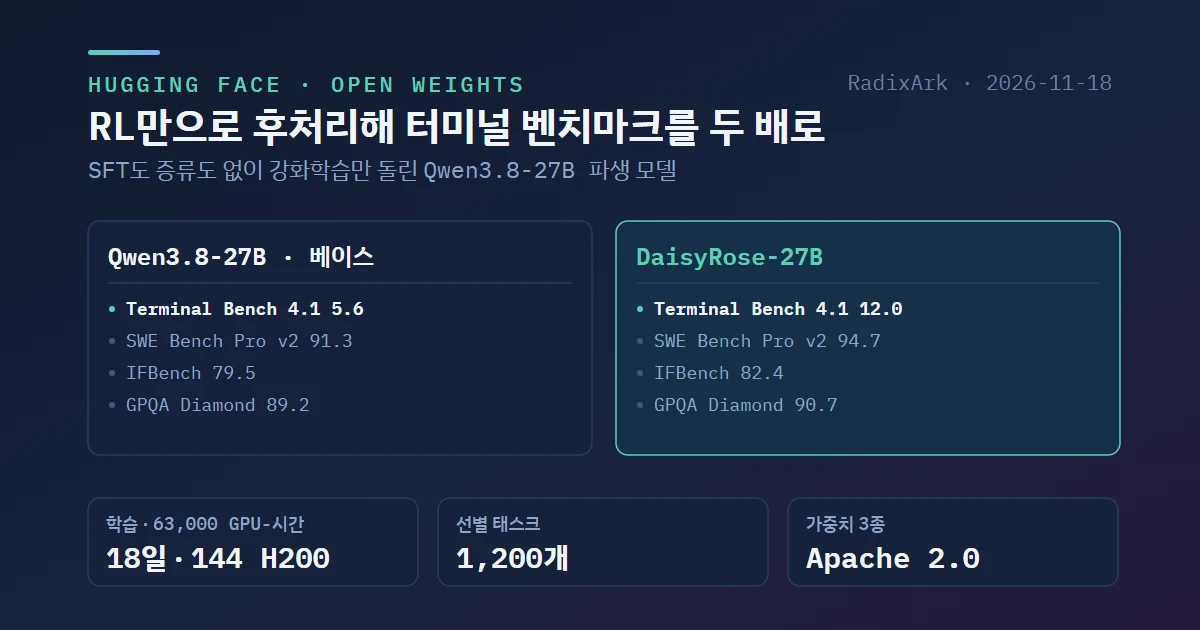
RadixArk가 첫 모델 DaisyRose-27B를 Hugging Face에 공개했다. Qwen3.8-27B를 받아 지도 미세조정도 증류도 없이 강화학습만 돌렸고, 144장짜리 H200 노드에서 18일을 태워 Terminal Bench 4.1 pass@1을 5.6에서 12.0으로 올렸다. 가중치는 Apache 2.0으로 BF16·FP8·NVFP4 세 종류가 올라와 있어 받아서 바로 띄울 수 있다. (이 글의 초안은 Orca Bots 가 작성했고, Claude가 검수 후 발행했다.)
TL;DR: Qwen3.8-27B 파생 모델을 RL만으로 후처리해 Terminal Bench 4.1을 5.6 → 12.0, SWE Bench Pro v2를 91.3 → 94.7로 올렸다. 아키텍처·토크나이저·챗 템플릿을 그대로 물려받아 기존 서빙 스택에 드롭인으로 들어간다. 가중치는 Apache 2.0(BF16 52GB / FP8 29GB / NVFP4 23GB)이고, 모델 카드에 SGLang + DSpark 실행 명령이 플래그까지 적혀 있다. 단 베이스 점수의 출처가 모델 카드 안에서 엇갈리니 “두 배”는 그대로 믿지 말고 자기 하네스로 다시 재는 편이 안전하다.
베이스에서 무엇만 바꿨나
베이스는 Qwen3.8-27B다. 아키텍처·토크나이저·챗 템플릿·이미지 이해·256K 컨텍스트를 전부 그대로 두고 가중치만 바꿨다. 기존 추론 스택을 손대지 않고 모델 경로만 갈아 끼우면 된다는 뜻이다. 전체 27.8B에는 비전 인코더 0.46B와 멀티 토큰 예측 헤드 0.42B가 포함돼 있다.
학습 자체는 단순하다. SFT도 증류도 없이 강화학습 하나만 썼다. 선별한 롱호라이즌 에이전트 태스크 1,200개를 18일간 H200 144장으로 돌렸고, 합계는 약 63,000 GPU-시간이다.
원문 근거
"DaisyRose-27B improves Terminal-Bench 4.1 pass@1 from 5.6% to 12.0%. Beyond Terminal-Bench 4.1, it also delivers gains on a variety of other reasoning, instruction following, and coding benchmarks."
베이스 대비 성적
모델 카드의 평가 표에서 베이스와 DaisyRose만 뽑았다. 일곱 항목 전부 올랐다.
| 벤치마크 | Qwen3.8-27B | DaisyRose-27B | 평가 설정 |
|---|---|---|---|
| Terminal Bench 4.1 | 5.6 | 12.0 | 태스크당 8회 평균, 내부 mini-swe-agent 하네스(요약 켬) |
| Terminal Bench 2.1 | 73.0 | 75.5 | 태스크당 5회 평균, Terminus 2 하네스 |
| DeepSWE v1.1 | 42.2 | 46.2 | 태스크당 8회 평균, mini-swe-agent |
| SWE Bench Pro v2 | 91.3 | 94.7 | 태스크당 5회 평균, mini-swe-agent. 베이스 점수는 논문 Table 3의 642 태스크 전체 |
| HLE (텍스트 전용) | 33.9 | 34.3 | 문항당 5회 평균, GPT-6 Luna 채점, 도구 없음 |
| IFBench | 79.5 | 82.4 | 프롬프트당 4회 평균(300개), allenai/IFBench 공식 스코어러 |
| GPQA Diamond | 89.2 | 90.7 | 문항당 8회 평균(198문항), simple-evals 템플릿 |
DaisyRose 쪽 숫자는 BF16과 FP8 실행 중 높은 값이고, 둘 다 잰 항목에서 차이는 1점 미만이었다.
원문 근거
"DaisyRose-27B scores higher than the original Qwen3.8-27B model on every benchmark above. The largest gain is on Terminal Bench 4.1, where pass@1 rises from 5.6% to 12.0%."
"Averaged over 8 repetitions per task, internal mini-swe-agent harness with summarization enabled."
"Averaged over 5 repetitions per task, mini-swe-agent harness. Qwen3.8-27B score from Table 3 of the SWE Bench Pro v2 paper (full 642-task set, mini-swe-agent)."
“5.6 → 12.0”을 그대로 읽으면 안 되는 이유
모델 카드의 출처 주석을 보면 Terminal Bench 4.1 행의 숫자가 전부 같은 곳에서 온 게 아니다. 4.1 항목이 없는 모델은 4.0 점수를 대신 싣는다고 밝혀 놓고, Qwen3.8-27B를 Muse Glimmer-30B·Qwen3.6-35B-A3B와 함께 그 목록(Artificial Analysis 출처)에 올려 뒀다. 정작 본문은 같은 5.6을 4.1 값이라고 설명한다. 모델 카드 안에서 두 설명이 어긋나 있고 어느 쪽이 맞는지는 정리해 주지 않는다.
공식 4.1 리더보드에서 가져왔다고 명시한 건 MiMo V2.6 Flash·Inkling 2 Small·Beam 1.0(mini-swe-agent)과 GPT-6 Luna(Codex, max effort)뿐이다. 그러니 “두 배”는 같은 조건에서 잰 두 값의 비율이 아닐 수 있다. 올랐다는 방향은 믿을 만하지만, 폭을 기준으로 도입을 판단할 거라면 자기 하네스로 베이스와 DaisyRose를 같이 돌려 보는 편이 맞다. 참고로 이 주석은 4.1 행에만 붙고 2.1 행에는 적용되지 않는다.
다른 모델들과 나란히 놓으면
모델 카드 표에는 베이스 말고도 일곱 모델이 더 있다. Terminal Bench 4.1 기준으로 DaisyRose(12.0)보다 높은 건 셋이다.
| 모델 | 활성 / 전체 파라미터 | Terminal Bench 4.1 |
|---|---|---|
| MiMo V2.6 Flash | 15B / 309B | 16.1 |
| GPT-6 Luna | 비공개 | 15.2 |
| Inkling 2 Small | 17B / 594B | 13.0 |
| DaisyRose-27B | 27B / 27B | 12.0 |
| Muse Spark Open | 42B / 816B | 6.6 |
| Beam 1.0 | 23B / 501B | 6.4 |
| Qwen3.8-27B | 27B / 27B | 5.6 |
위에 있는 셋은 전부 MoE이거나 비공개 모델이고 전체 파라미터가 한 자릿수 배 이상 크다. 반대로 전체 816B인 Muse Spark Open과 501B인 Beam 1.0은 27B 덴스 모델인 DaisyRose보다 아래에 있다. 이 표에서 읽을 건 순위가 아니라 27B 한 장짜리 모델이 들어갈 수 있는 자리다.
받을 수 있는 가중치
| 정밀도 | 모델 ID | 크기 | 비고 |
|---|---|---|---|
| BF16 | RadixArk/DaisyRose-27B |
약 52 GB | 기준 체크포인트 |
| FP8 | RadixArk/DaisyRose-27B-FP8 |
약 29 GB | H100·H200 |
| NVFP4 | RadixArk/DaisyRose-27B-NVFP4 |
약 23 GB | Blackwell 필요 |
GGUF 변환본(RadixArk/DaisyRose-27B-GGUF)도 올라와 있다. 라이선스는 Apache 2.0이고 베이스인 Qwen3.8-27B도 Apache 2.0이라 파생 배포에 걸릴 게 없다.
하드웨어 요구는 생각보다 낮다. 모델 카드는 H200·B200·GB300 같은 데이터센터 카드뿐 아니라 RTX PRO 6000, RTX 5090, DGX Spark에서도 단일 GPU로 돌아간다고 적어 뒀다.
띄우기 — SGLang + DSpark
권장 조합은 SGLang에 DSpark 추측 디코딩을 붙이는 것이다. DSpark는 공식 lmsysorg/sglang:latest 이미지에 이미 들어 있다. 아래는 모델 카드가 BF16 4-GPU 노드용으로 제시한 명령이다.
docker run --gpus all --ipc=host --shm-size 32g -p 30000:30000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  lmsysorg/sglang:latest \
  python3 -m sglang.launch_server \
  --model-path RadixArk/DaisyRose-27B \
  --served-model-name DaisyRose-27B \
  --tp-size 1 --dp-size 4 \
  --context-length 262144 \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --trust-remote-code \
  --mem-fraction-static 0.85 \
  --kv-cache-dtype fp8_e4m3 \
  --chunked-prefill-size 2048 \
  --mamba-full-memory-ratio 11.01 \
  --mamba-radix-cache-strategy extra_buffer_lazy \
  --mamba-ssm-dtype float32 \
  --speculative-algorithm DSPARK \
  --speculative-draft-model-path RadixArk/Qwen3.8-27B-DSpark \
  --speculative-draft-attention-backend flashinfer \
  --host 0.0.0.0 --port 30000
--tp-size 1 --dp-size 4는 GPU 네 장에 복제본을 하나씩 올리는 구성이다. 장비가 다르면 두 값을 조절하거나 FP8·NVFP4 체크포인트로 바꾸면 되고, GPU별 프리셋은 SGLang 쿡북이 만들어 준다. 추측 디코딩용 드래프트 모델 RadixArk/Qwen3.8-27B-DSpark는 별도 저장소라 함께 내려받아야 한다.
서버가 뜨면 OpenAI 호환 엔드포인트로 그대로 보낸다. 이 모델은 기본이 생각 모드라 사고 과정은 reasoning_content, 최종 답변은 content로 나뉘어 돌아온다.
from openai import OpenAI

client = OpenAI(base_url="http://localhost:30000/v1", api_key="none")
SAMPLING = dict(temperature=1.0, top_p=0.95, extra_body={"top_k": 20, "min_p": 0.0})

resp = client.chat.completions.create(
    model="DaisyRose-27B",
    messages=[{"role": "user", "content": "How many positive divisors does 360 have?"}],
    **SAMPLING,
)
print(resp.choices[0].message.reasoning_content)  # 사고 과정
print(resp.choices[0].message.content)            # 최종 답변
샘플링은 temperature=1.0, top_p=0.95, top_k=20, min_p=0을 쓰라고 못박아 뒀다. 어려운 문제에서는 max_tokens를 걸지 않는 쪽을 권한다 — 긴 사고는 수만 토큰까지 간다. 멀티턴에서는 이전 턴의 reasoning_content를 함께 돌려보내야 한다. 챗 템플릿이 그 맥락을 유지하도록 돼 있어서, 빼고 보내면 앞 턴의 사고가 끊긴다.
원문 근거
"We strongly recommend serving DaisyRose-27B with SGLang and DSpark speculative decoding, using the official lmsysorg/sglang:latest Docker image (DSpark is included)."
"Use `temperature 1.0`, `top_p 0.95`, `top_k 20`, `min_p 0` in thinking mode."
"In multi-turn chats, send earlier turns back with their reasoning_content; the chat template keeps it by default."
학습 쪽에서 가져갈 것 — Miles와 샌드박스
모델보다 재사용 가치가 큰 건 학습 인프라 쪽 수치다. 둘 다 오픈소스다.
Miles — 완전 비동기 RL
RadixArk는 자체 RL 프레임워크 Miles를 완전 비동기 모드로 돌렸다. 에이전트가 태스크를 푸는 동안 트레이너가 학습하고, 어느 쪽도 상대를 기다리지 않는다. 144장의 분배는 추론(SGLang 서빙) 128장, 트레이너 16장이다. 세션이 1M 토큰까지 길어지면 하네스 요약으로 여러 궤적으로 쪼개 학습에 넣는다.
공개한 비교값은 이렇다.
- MFU 37% 대 16% — Megatron 기반 오픈소스 트레이너와 같은 조건에서. 같은 학습에 GPU 시간이 57% 덜 든다는 뜻이다
- 엔드투엔드 16,800 토큰/초 대 8,300 토큰/초 — 같은 144장 기준, 에이전트가 태스크에 쓰는 시간까지 포함한 값
- MoE에서는 격차가 더 벌어진다 — Qwen3.6-35B-A3B 6.2배, 약 300B급 GLM-5.3-Flash에서 10배 이상
원문 근거
"RadixArk trained DaisyRose-27B with Miles, our open-source reinforcement learning framework for large-scale model post-training, in fully asynchronous mode: the agent keeps working while the model learns, and neither waits for the other."
"On this release, 37% of each GPU's peak compute went into useful training work (model FLOPs utilization, or MFU) on our backend. The open-source trainer, built on Megatron, reached 16% on comparable runs. So the same training needs 57% less GPU time."
"Counting the time the agent spends on its tasks, the release run trained on about 16,800 tokens per second across its 144 GPUs. The open-source trainer reached about 8,300 on the same GPUs."
샌드박스를 직접 돌린 결과
에이전트 RL은 샌드박스를 얼마나 싸고 안정적으로 찍어 내느냐가 곧 처리량이다. 9월 중순부터 11월 중순까지 약 94만 4천 개의 샌드박스를 돌렸고 동시 실행은 최대 1,566개였다. 머신은 한 대에서 최대 열두 대까지 늘렸고 업그레이드를 열 번 거쳤다.
생성 성공률은 9주 전체로 99%, 10월 말 이후로는 99.95%를 넘겼다. 상용 클라우드 샌드박스를 쓰는 것보다 인프라 비용이 약 80% 낮았다고 한다. 기반은 오픈소스 AgentENV다.
원문 근거
"Between mid-September and mid-November, it ran about 944,000 sandboxes for this project, with up to 1,566 running concurrently."
"Across all nine weeks, 99% of sandbox creations succeeded; since late October, that figure has exceeded 99.95%."
"Cloud infrastructure costs for the project's sandboxes were about 80% lower than running the same sandboxes with popular cloud sandbox providers."
태스크 1,200개를 고른 기준
Eigent AI와 함께 수천 개 후보에서 1,200개를 추렸다. 기준 셋이 그대로 따라 할 만하다.
- 베이스가 틀리는 지점을 겨냥한다. Qwen3.8-27B를 모든 태스크에 돌려 보고, 고치고 싶은 실수를 중심으로 태스크를 다시 설계했다. 그다음 정답률이 학습에 쓸모 있는 구간에 들어올 때까지 난이도를 조절했다
- 여러 단계가 서로 물리게 만든다. 한 시도에 샌드박스 1.5시간, 툴 호출 100회 이상, 출력 토큰 256K 이상이 걸리는 길이다
- 우회로 통과하는 태스크를 솎아 낸다. 모델의 시도를 사람이 같이 열어 보고, 의도한 문제를 풀지 않고도 통과되거나 설계에 결함이 있는 태스크는 고치거나 버렸다
세 번째가 핵심이다. 평가를 자동화해 두면 모델은 반드시 채점기의 빈틈을 먼저 찾는다. 보상이 “풀었다”가 아니라 “통과했다”에 붙어 있으면 학습은 그쪽으로 수렴한다.
원문 근거
"Each task targets a mistake the original model makes. We ran Qwen3.8-27B on every task and redesigned each one around the mistakes we wanted the model to stop making. We then adjusted the difficulty until the solve rate fell within a useful learning range."
"Each attempt gets up to 1.5 hours in a sandbox, with more than 100 tool calls and more than 256K output tokens."
"Tasks must reward actually solving the problem. We reviewed every task alongside the model's attempts. Tasks that could be passed without solving the intended problem, or that contained a design flaw, were fixed or removed."
참고
- 원문 블로그: DaisyRose-27B: Pushing the Frontier of Post-Training (RadixArk, 2026-11-18)
- 모델 카드: RadixArk/DaisyRose-27B — 평가 설정과 출처 주석, 실행 명령이 여기 있다
- SGLang 쿡북 — DaisyRose-27B
- radixark/miles — 비동기 RL 프레임워크
- kvcache-ai/AgentENV — 샌드박스 기반
- RadixArk 자체 블로그: DaisyRose-27B