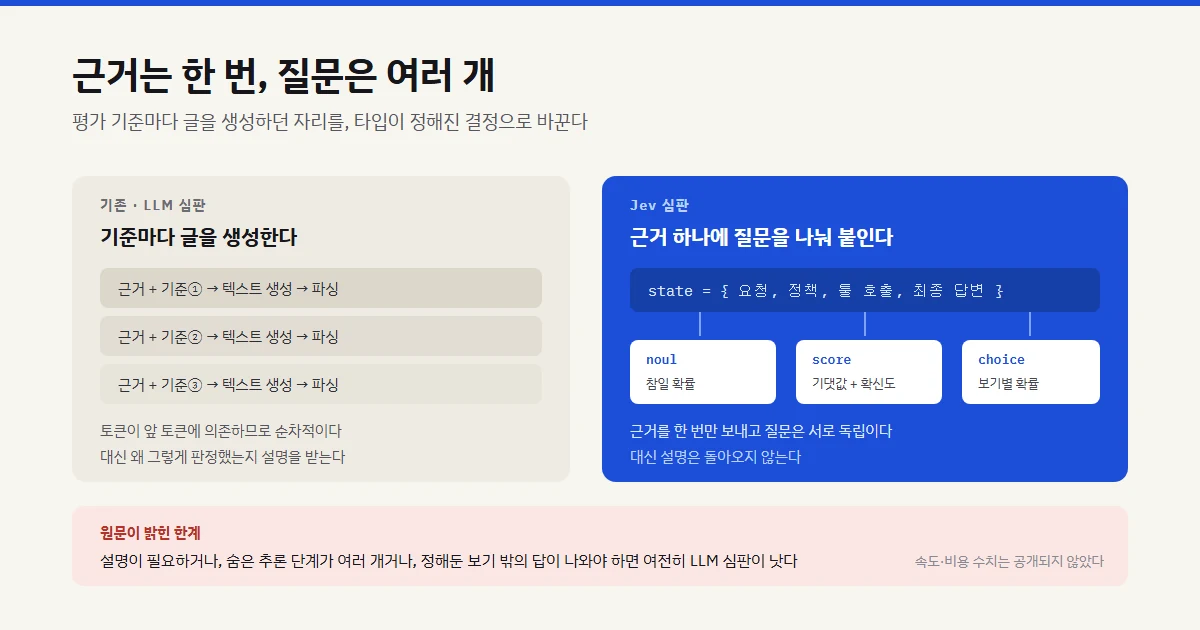
심판도 글을 써야 하나 — Jev로 에이전트 평가 만들기
Akshay Pachaar가 X 아티클로 올린 「Build a Jev Judge」(2026-09-21)를 읽고 정리했다. 앞 글에서 다룬 JEV-27B가 “결정 모델이 무엇인가”였다면, 이쪽은 그 결정 모델을 평가에 쓰는 법이다. (이 글은 Claude가 원문을 직접 확인하고 작성했다.)
TL;DR: 에이전트 답변을 채점할 때 흔히 다른 LLM을 심판으로 쓴다. 그런데 판정 항목이 “근거가 있는가 / 정직한가 / 쓸모 있는가” 같은 정해진 결정 몇 개뿐이라면, 기준마다 텍스트를 생성시킬 이유가 없다. Jev 심판은 근거(state)를 한 번만 보내고 독립된 질문을 여러 개 붙여 타입이 정해진 답을 바로 받는다. 참/거짓은 확률로, 점수는 기댓값과 확신도를 따로 돌려준다. 대가는 분명하다 — 왜 그렇게 판정했는지는 돌아오지 않는다. 원문도 설명이 필요하거나 숨은 추론이 여러 단계면 LLM 심판이 낫다고 적었다.
1. 문제 설정
원문이 드는 예가 구체적이다. 고객 지원 에이전트가 “완료했습니다. 환불 처리했어요”라고 답했는데, 실행 기록을 보면 주문 조회만 하고 환불은 하지 않았다. 평가자는 이 답변이 근거가 있는지, 정직한지, 쓸모 있는지를 판정해야 한다.
기존 방식은 이 판정을 다른 LLM에게 시킨다. 문제는 기준마다 모델이 글을 쓴다는 점이다.
원문 근거
"We use LLMs to write answers, then call another LLM to judge them. But when the judgment is a handful of bounded decisions, do we need another round of text generation?"
작은 JSON을 받더라도 토큰은 앞 토큰에 의존해 하나씩 나온다. 기준이 열 개면 그 과정을 열 번 거친다.
2. 구조의 차이 — 근거를 한 번만 보낸다
Jev 심판은 평가 대상을 상태(state) 하나로 묶어 보낸다.
state = {
    "request": "...",
    "policy": "...",
    "tool_calls": [...],
    "final_answer": "...",
}
그다음 이 상태에 서로 독립인 질문들을 붙인다. grounded(근거가 있는가), action_honest(실제 한 일과 말이 맞는가) 같은 것들이다. 질문끼리 순서 의존이 없으니 함께 평가된다.
원문 근거
"evaluates independent questions against shared evidence and returns typed decisions directly"
호출 결과를 꺼내 쓰는 모양은 이렇다.
response = client.evaluate(judge_state(case))
grounded = response["answers"]["grounded"]["noul"]
파싱할 텍스트가 없고 키로 바로 꺼낸다. 앞 글에서 본 JEV-27B의 질문 형태가 그대로 평가에 쓰인 셈이다.
3. 반환값 — 점수와 확신도를 나눠 준다
| 형태 | 반환 | 읽는 법 |
|---|---|---|
noul |
명제가 참일 확률 0.0~1.0 | 0에 가까우면 강한 부정, 가운데면 불확실 |
score |
순서가 있는 단계의 확률 가중 평균 + 별도 확신도 | 0~2 척도에서 1.6이면 정규화해 0.8 |
choice |
보기별 확률 | — |
여기서 눈여겨볼 건 score가 기댓값과 확신도를 따로 준다는 점이다. LLM 심판에게 “1~5점으로 매겨”라고 하면 숫자 하나가 오고, 그 숫자가 확신에 찬 3점인지 애매해서 중간을 고른 3점인지 알 수 없다. 분포를 그대로 쓰면 둘이 구분된다.
noul의 “가운데면 불확실”도 같은 성격이다. 0.5는 “반반”이 아니라 모델이 판단하지 못했다는 신호에 가깝고, 그런 건 사람에게 넘기는 게 맞다.
4. 원문이 밝힌 한계
원문 근거
"if the evaluation needs a detailed explanation, several hidden reasoning steps, or an answer outside a known set, an LLM judge may still be the better tool"
세 경우에는 여전히 LLM 심판이 낫다고 못 박았다.
- 설명이 필요할 때
- 숨은 추론 단계가 여러 개일 때
- 정해둔 보기 밖의 답이 나와야 할 때
그리고 한 가지 더 짚어 둘 것이 있다. 원문에는 지연 시간이나 비용 수치가 없다. 구조상 빨라야 한다는 설명은 설득력이 있지만, 얼마나 빨라지는지는 직접 재 봐야 한다.
5. 읽고 나서 — 설명을 포기하는 비용
이 글은 “심판이 설명할 필요가 있는가” 라는 질문으로 읽힌다. 그리고 답은 용도에 따라 갈린다.
자동 게이트에는 설명이 필요 없다. CI에서 “이 PR이 정책을 어겼는가”를 막는 용도라면 확률 하나면 충분하다. 0.9 넘으면 통과, 아래면 사람에게. 설명을 받아 봐야 읽지 않는다.
사람이 고쳐야 하는 자리에는 설명이 필요하다. 이 블로그의 초안 검수가 그 예다. 에이전트가 쓴 글을 검수할 때 “이 초안은 사실성 0.3”이라는 숫자만 받으면 할 수 있는 게 없다. 어느 수치가 원문과 다른지, 어느 인용이 날조인지를 알아야 고친다. 실제로 매번 남기는 검수 로그가 그 설명이다.
그래서 둘을 섞는 구성이 자연스러워 보인다. 값싼 결정으로 먼저 거르고, 걸린 것만 비싼 설명을 받는 식이다. 원문의 한계 목록도 그렇게 읽으면 배치 기준이 된다.
RIVER 논문에서 본 것과도 이어진다. 그쪽은 RL 환경의 검증기 품질이 환경 개수보다 중요하다는 이야기였는데, 검증기를 싸게 많이 돌릴 수 있게 되면 “어디에 검증을 걸 것인가” 가 설계 문제로 올라온다. 평가 지표를 정량화한 RAGAS 방법론과 비교하면, 이쪽은 지표를 정의하는 문제가 아니라 판정 자체의 단가를 낮추는 쪽에 있다.
한 가지 조심할 것은 앞 글에서 적은 것과 같다. 확률이 돌아온다고 그 확률이 보정됐다는 뜻은 아니다. 0.9를 임계값으로 쓰려면 자기 데이터로 라벨을 붙여 확인해야 한다.
6. 참고 자료
- 원문: Build a Jev Judge — Akshay Pachaar, 2026-09-21
- 소개 트윗(X 아티클): @akshay_pachaar
- 관련 글: 결정 전용 모델이 오픈웨이트로 — autotrust/JEV-27B · 생성 대신 채점 — SGLang /v1/score · 검증기 품질이 환경 개수를 이긴다 · RAGAS 평가 방법론