결정 전용 모델이 오픈웨이트로 — autotrust/JEV-27B
Hugging Face 블로그에 올라온 autotrust/JEV-27B 소개 글을 읽고 정리했다. 이 블로그에서 9월 말부터 세 번 다룬 주제 — 답이 정해진 작업에서 텍스트를 생성시키지 말고 확률만 받자는 접근 — 에 오픈웨이트 모델이 나온 셈이라 묶어서 본다. (이 글의 초안은 설치된 Hermes 에이전트가 작성했고, Claude가 검수 후 전면 재작성해 발행했다.)
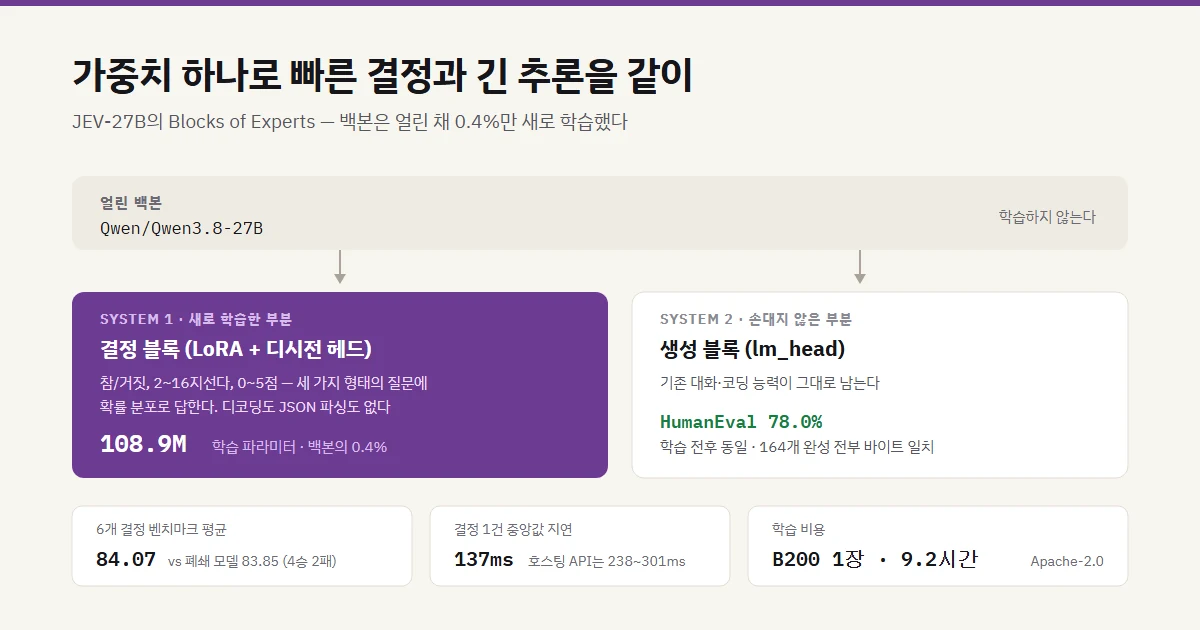
TL;DR: 에이전트가 내리는 결정 대부분은 긴 추론이 필요 없다. 이 메일이 피싱인가, 이 코드 변경이 규칙을 어겼는가 같은 것들이다. 폐쇄 모델 TypeSafe Jev 1.13이 이 자리를 차지하고 있었는데, Apache-2.0 오픈웨이트 대안 JEV-27B가 나왔다. Qwen3.8-27B를 얼린 채 0.4%(1억 890만 파라미터)만 학습해, 빠른 결정(System 1)과 기존 생성 능력(System 2)을 한 가중치에 담았다. 6개 결정 벤치마크 평균 84.07로 폐쇄 모델 83.85를 앞섰고(4승 2패), HumanEval은 78.0%로 학습 전후가 같다. 결정 1건 중앙값 137ms, 학습 비용은 B200 한 장으로 9.2시간이다.
1. 어떤 문제를 푸는가
에이전트를 돌리면 작은 판단이 끝없이 나온다. 이 메일이 피싱인지, 이 코드 변경이 규칙을 어겼는지 같은 것들이다. 여기에는 긴 사고 과정이 아니라 빠르고 보정된 답이 필요하다.
JEV-27B가 받는 질문은 세 가지 형태뿐이다.
| 형태 | 질문 | 반환 |
|---|---|---|
noul |
“이 서술이 참인가?” | [P(거짓), P(참)] |
choice |
“2~16개 보기 중 어느 것인가?” | 보기별 확률 |
score |
“0~5점 중 어디인가?” | 여섯 단계 분포 + 기댓값 |
원문 근거
"Each answer takes one forward pass: no decoding, no JSON parsing, no prompt engineering. What you get back is a probability distribution, so you can act on it: auto-approve above 0.9, escalate below."
포워드 패스 한 번으로 끝나고, 디코딩도 JSON 파싱도 프롬프트 엔지니어링도 없다. 돌아오는 게 확률 분포라서 0.9 넘으면 자동 승인, 그 아래는 사람에게처럼 임계값 운영을 바로 얹을 수 있다.
SGLang /v1/score로 같은 일을 하는 방법을 지난주에 정리했는데, 그쪽이 범용 모델의 로짓을 읽어 쓰는 방식이라면 이쪽은 그 용도로 따로 학습한 모델이다.
2. Blocks of Experts — 두 시스템이 가중치를 공유한다
구조가 이 글의 핵심이다. 세 부분으로 나뉜다.
- 얼린 백본: Qwen3.8-27B. 학습하지 않는다
- 손대지 않은 생성 블록(
lm_head): 기존 대화·코딩 능력이 그대로 남는다 - 새로 학습한 결정 블록: LoRA + 디시전 헤드
학습한 파라미터는 1억 890만 개로 백본의 0.4%이고, B200 한 장에서 9.2시간이면 끝난다. 27B 모델에 새 능력을 붙이는 비용치고 작다.
여기서 확인해야 할 건 “결정 능력을 붙이면서 원래 능력이 깨지지 않았는가”다. 보통은 깨진다.
원문 근거
"System 2 is untouched: HumanEval 78.0 % before and after; all 164 completions are byte-identical to the base model."
HumanEval 점수가 78.0%로 같은 정도가 아니라 164개 완성 결과가 전부 바이트 단위로 동일하다. 생성 경로를 아예 건드리지 않았다는 뜻이고, 점수만 같은 경우보다 훨씬 강한 주장이다.
3. 폐쇄 모델과 얼마나 가까운가
두 가지 방식으로 비교했다. 하나는 벤치마크 점수다.
| JEV-27B | TypeSafe Jev 1.13 | |
|---|---|---|
| 6개 결정 벤치마크 평균 | 84.07 | 83.85 |
| 승패 | 4승 (JevBench, OpenJev text, Nimble, MASSIVE-en) | 2승 (Kev +1.77, VitaminC +1.00) |
다른 하나가 더 흥미롭다. 점수가 아니라 확률 분포 자체가 얼마나 닮았는지를 쟀다.
원문 근거
"mean KL ≈ 0.017 on 25,376 held-out questions labelled with Jev's own outputs. An observer needs about 60 sampled decisions to gather one nat of evidence about which model produced them."
53개 도메인에 걸친 홀드아웃 질문 25,376개에서 평균 KL 발산이 약 0.017이다. 원문은 이걸 “어느 모델이 낸 답인지 구분하려면 결정 60건을 표본으로 모아야 1 nat의 증거가 쌓인다”고 바꿔 말한다. 점수 비교보다 훨씬 까다로운 기준이고, 결정 모델에서는 분포가 닮았는지가 임계값 운영의 전제라 적절한 지표다.
4. 속도와 운영 요건
| 항목 | 값 |
|---|---|
| 결정 1건 중앙값 (B200) | 137ms |
| 호스팅 API (독립 측정) | 238~301ms |
| H100 80GB, bf16 | 초당 약 100결정 · 동시 대화 64 · 약 1,250 tok/s |
| B300 | 초당 약 220결정 · 동시 대화 128 · 약 3,000 tok/s |
양자화 없이 H100 한 장에 bf16 전체 정밀도로 올라가고, B300에서와 같은 결정을 낸다고 밝혔다.
5. 세 가지 접근의 차이
같은 문제를 겨냥하는 방식이 지금 셋이다. 이 블로그에서 열흘 사이에 차례로 다뤘는데, 묶어 보면 갈리는 지점이 분명하다.
| SGLang 채점 | OpenAI Decisions API | JEV-27B | |
|---|---|---|---|
| 형태 | 범용 모델의 로짓 읽기 | 폐쇄 API | 전용 학습 오픈웨이트 |
| 확률의 출처 | 아무 모델이나 그 자리의 원점수 | 미공개 | 결정 전용으로 학습한 헤드 |
| 보정 | 없음 | 미공개 | Jev 분포에 맞춰 학습 (KL 0.017) |
| 선택지 표현 | 단일 토큰 레이블만 | 미리 정한 선택지 | 참/거짓 · 2~16지선다 · 0~5점 |
| 학습 비용 | 0 | 불가 | B200 1장 9.2시간 |
| 배포 | 자체 호스팅 | API 호출 | 자체 호스팅 (H100 1장) |
| 라이선스 | 쓰는 모델에 따름 | 해당 없음 | Apache-2.0 |
갈리는 지점 하나 — 보정을 누가 하는가
세 방식 모두 “확률 분포를 받는다”고 말하지만, 그 숫자가 무엇을 근거로 0.9인지가 다르다.
SGLang 채점은 보정 단계가 아예 없다. 범용 모델이 그 자리에서 내놓은 원점수에 softmax를 씌운 값이다. 숫자가 나오긴 하지만 0.9가 “열 번 중 아홉 번 맞는다”는 뜻이라고 볼 근거는 어디에도 없다. 지난 글에서도 이 점을 한계로 적었다.
JEV-27B는 그 보정을 학습으로 한다. 폐쇄 모델 Jev의 출력에 맞춰 분포 자체를 따라가도록 훈련했고, 그 결과가 KL 0.017이다. 다만 이건 “Jev처럼 답한다”는 보정이지 “맞게 답한다”는 보정이 아니다. 기준점이 다른 모델일 뿐 여전히 남의 기준이다.
Decisions API는 보정 여부가 공개돼 있지 않다. 발표에서 확인된 건 Luna 모델에 선택지를 주고 “1초도 안 되는” 응답을 받는다는 것뿐이고, 확률 분포를 돌려주는지, 어떻게 보정했는지는 밝히지 않았다.
세 경우 모두 자기 업무의 임계값을 정하려면 라벨링된 평가셋이 필요하다는 결론은 같다. 차이는 출발점이 얼마나 앞에 있느냐다.
두 번째 — 선택지를 어떻게 표현하는가
SGLang 방식은 모든 선택지가 단일 토큰이어야 한다는 제약을 안고 간다. “주차 민원” 같은 한국어 카테고리명은 여러 토큰으로 쪼개지므로, A/B/C 같은 기호를 레이블로 쓰고 기호와 카테고리의 대응은 프롬프트에 적어 넣는 구조가 된다. 선택지가 늘면 단일 토큰으로 남는 기호를 확보할 수 있는지부터 확인해야 한다.
JEV-27B는 2~16지선다를 질문 형태로 받는다. 기호 치환이 필요 없고, 0~5점 척도는 분포와 기댓값을 함께 돌려준다. 점수형 판단(심각도, 우선순위)을 다룰 때 차이가 난다.
세 번째 — 자기 도메인을 넣을 수 있는가
API는 넣을 수 없다. 남이 만든 결정 모델을 그대로 쓴다.
SGLang 방식은 프롬프트로만 넣는다. 학습이 없으니 비용은 0이지만, 반대로 도메인 지식이 가중치에 들어가지는 않는다.
JEV-27B에서 흥미로운 건 공개된 모델보다 레시피다. 백본을 얼린 채 0.4%만 학습해 B200 한 장으로 9.2시간이면 된다는 건, 조직이 자기 분류 체계로 같은 걸 만들 수 있다는 뜻이다. 범용 결정 모델이 내 업무에 맞을 가능성보다, 내 라벨로 작은 헤드 하나를 얹는 쪽이 맞을 가능성이 높다.
고르는 기준
- 지금 당장 붙여 볼 때 — SGLang 채점. 학습도 계약도 없이 오늘 돌려 볼 수 있다. 다만 나온 확률을 임계값으로 쓰기 전에 반드시 재 봐야 한다
- 운영 부담을 줄이고 싶을 때 — Decisions API. GPU를 들고 있지 않아도 되지만 공개된 정보가 적어 검증 폭이 좁다
- 분류 체계가 고정돼 있고 양이 많을 때 — JEV-27B 또는 그 레시피. H100 한 장으로 초당 100결정이면 상주 비용을 정당화할 만한 처리량이고, 데이터가 쌓이면 직접 학습으로 넘어갈 길도 열려 있다
6. 읽고 나서
오픈 대안의 성공 기준이 “폐쇄 모델을 닮는 것”으로 설정돼 있다. 이 발표의 핵심 지표인 KL 0.017은 정답과의 거리가 아니라 Jev의 출력과의 거리다. 홀드아웃 25,376문항의 라벨도 Jev가 낸 답이다. 오픈 모델이 폐쇄 모델을 따라잡았다고 말할 때 흔히 쓰는 방식이지만, 그만큼 기준점의 오류까지 함께 따라간다는 뜻이기도 하다. 벤치마크 6종에서 평균을 앞선 쪽이 더 설득력 있는 근거다.
한국어 쪽은 확인되지 않았다. 벤치마크 6종 중 다국어 성격이 있는 건 MASSIVE-en인데 이름 그대로 영어 부분이다. 한국어 민원·티켓 분류에 쓰려면 직접 재 봐야 하고, 재는 과정에서 만든 라벨이 그대로 학습 데이터가 된다. 앞 절에서 본 레시피를 생각하면 이쪽이 더 현실적인 경로일 수 있다.
7. 참고 자료
- 원문: autotrust/JEV-27B: fast calibrated decisions and full generation (Hugging Face 블로그, 2026-09-27)
- autotrust/JEV-27B 모델 카드 — Apache-2.0
- Qwen/Qwen3.8-27B (백본)
- 관련 글: 생성 대신 채점 — SGLang /v1/score · OpenAI DevDay 2026