Neovim으로 LLM REST API 테스트하기 — kulala.nvim 설치부터 응답 후처리까지
API를 두드려 보는 일은 결국 셸에서 curl 한 줄로 끝나는데, 그 한 줄은 어디에도 남지 않는다. .http 파일은 다르다. 요청이 저장소에 함께 커밋되고, 변수로 환경을 갈아 끼우고, diff가 남는다. Neovim에서 그 파일을 그대로 실행해 주는 플러그인이 kulala.nvim이다. 그런데 2026년 11월 지금 문서대로 설치하면 라이선스 토큰부터 요구받는다. 이 글은 그 함정을 피해 에디터 안에서 LLM REST API를 테스트하는 환경을 세우는 과정이다 — 설치와 버전 고정, .http 변수 처리, 실패한 요청을 읽는 법, 응답 직후 후처리를 붙이는 법 순서로 간다. 손에 잡히는 예제가 있어야 하므로 개인정보 탐지 API 하나(fastino/gliner2-pii)를 실습 대상으로 삼았고, 뒤쪽의 라벨 enum·응답 파싱·한국어 후보정은 그것을 실제로 붙여 보면서 나온 기록이다. 앞서 쓴 Windows에서 Neovim 0.12 설정 다시 짜기의 vim.pack 환경을 그대로 이어 쓴다. (이 글은 Windows PC에서 직접 실행해 확인한 기록을 Claude가 공개 문서와 대조해 정리했다.)
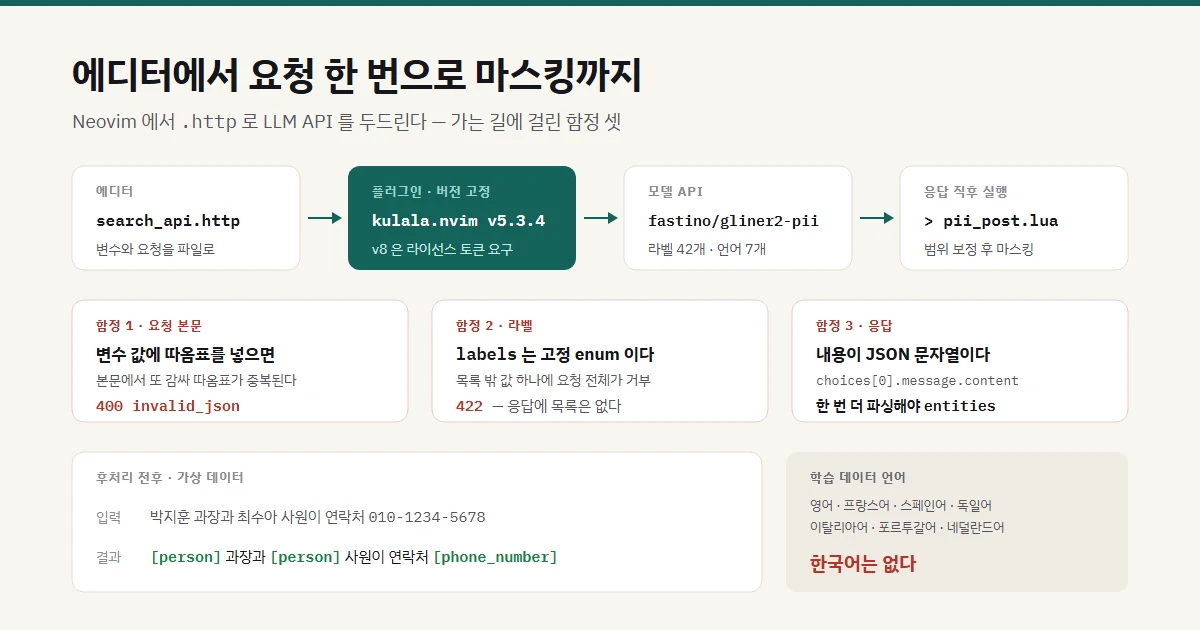
TL;DR — 환경: ① kulala.nvim 최신 8.x는 비공개로 전환된
kulala-core바이너리를 쓰고 모든 Kulala 도구에 라이선스 토큰을 요구한다. 토큰 없이 쓰려면 코어 도입 직전 버전인v5.3.4로 고정한다. ②.http에서@name="값"처럼 따옴표를 값에 넣고 본문에서"{{name}}"으로 또 감싸면 따옴표가 중복돼400 request body is not valid JSON이 난다.TL;DR — 실습 대상(PII 탐지 API): ③
gliner2-pii의labels는 42개 고정 enum이고 목록 밖 값이 하나만 섞여도 요청 전체가422로 거부되는데, 응답 본문에는 허용 목록이 들어 있지 않다. ④ 응답은 chat.completion 형태라choices[0].message.content를 한 번 더 JSON 파싱해야 엔티티가 나온다. ⑤ 이 모델의 학습 데이터 7개 언어에 한국어는 없고, 실제로 한국어 이름은 “김민준 대리가”처럼 직함·조사까지 범위에 들어온다. post-request 스크립트로 범위를 다듬었지만 라벨 자체가 틀린 경우(홍길동입니다→city)는 못 고친다.
설치 — 최신 버전은 라이선스 토큰을 요구한다
vim.pack.add에 저장소를 한 줄 추가하고 setup({})만 부르면 끝날 일이었다. 그런데 최신 버전(이 글 작성 시점 v8.0.1, 11월 18일)을 받으면 요청이 실행되지 않고 kulala-core를 찾을 수 없다는 오류가 난다. 코어 바이너리를 내려받으려면 토큰이 있어야 하고, 토큰은 저자에게 이슈로 요청해 받는 구조다. README가 그렇게 적고 있다.
원문 근거
"Kulala-Core went private and closed-source, All Kulala tools require a license token to run."
원문 근거
"To request a license token, please open an issue using the license request template."
“All Kulala tools”라고 적혀 있으니 플러그인 자체도 대상으로 읽힌다. 토큰을 받아 쓸 생각이라면 환경변수 KULALA_CORE_LICENSE_TOKEN으로 넣어 첫 실행 때 묻는 절차를 건너뛸 수 있다고 README가 안내한다. 저장소 dont-be-evil-company/kulala-core는 지금 404다 — 비공개로 돌렸다는 설명과 맞는다.
토큰 없이 쓰려면 코어 도입 직전 버전으로 고정하면 된다. 코어는 v6.0.0에서 들어왔고, 그 릴리스 노트의 변경 항목이 breaking: move to kulala-core이며 비교 링크가 v5.3.4...v6.0.0이다. 즉 v5.3.4가 순수 Lua와 외부 curl로 돌던 마지막 버전이다.
원문 근거
"v6.0.0 - Kulala.nvim finally meets Kulala-Core"
원문 근거
"No external curl ... node, openssl, websocat, grpcurl anymore. Just Kulala Core that does it all."
vim.pack은 version으로 태그를 그대로 고정할 수 있다.
-- vim.pack.add({ ... }) 목록에 한 줄
{ src = 'https://github.com/mistweaverco/kulala.nvim', version = 'v5.3.4' },
저장소 조직 이름이 mistweaverco에서 dont-be-evil-company로 바뀌었지만 옛 주소도 리다이렉트로 그대로 동작한다(이 환경에서 확인). 새 주소로 적어도 된다.
나머지 설정은 .http 확장자를 파일 타입으로 등록하고 키맵을 붙이는 정도다.
vim.filetype.add({ extension = { http = 'http' } })
require('kulala').setup({})

vim.api.nvim_create_autocmd('FileType', {
  group = vim.api.nvim_create_augroup('KulalaKeys', { clear = true }),
  pattern = 'http',
  callback = function(ev)
    local o = { buffer = ev.buf }
    vim.keymap.set('n', '<CR>',       function() require('kulala').run() end,         o)
    vim.keymap.set('n', '<leader>ra', function() require('kulala').run_all() end,     o)
    vim.keymap.set('n', ']r',         function() require('kulala').jump_next() end,   o)
    vim.keymap.set('n', '[r',         function() require('kulala').jump_prev() end,   o)
    vim.keymap.set('n', '<leader>rv', function() require('kulala').toggle_view() end, o)
  end,
})
커서가 올라간 요청을 <CR>로 실행하고, 파일 전체를 <leader>ra로 돌리고, 요청 사이를 ]r/[r로 건너뛰고, 응답 창의 보기 모드를 <leader>rv로 바꾼다. 여기까지가 headless 실행으로 설치·로드·요청(200)까지 확인한 범위다. 키맵이 GUI(Neovide)에서 실제로 눌리는 것은 각자 확인해야 한다.
남은 경고와 버그 하나
시작할 때 Nvim-treesitter not found. kulala_http parser is required 경고가 뜬다. 요청 실행에는 지장이 없고 구문 강조와 포맷만 안 된다. 이 PC에는 C 컴파일러가 없어 kulala_http 파서를 빌드하지 않았고, 그래서 이 항목은 미해결로 남겨 뒀다. 참고로 v5.3.4 릴리스 노트에는 feat: allow using kulala_http parser without nvim-treesitter (#801) 항목이 있다.
v5.3.4에서 실제로 걸린 버그가 하나 있다. 요청을 실행한 뒤 .http 파일에서 줄을 지우고, 응답 창에서 <CR>(Jump to response)을 누르면 E5108: Invalid cursor line: out of range로 죽는다. 요청이 있던 줄 번호를 그대로 들고 있다가 범위 밖을 가리키는 것이다. 되돌릴 방법이 없어 해당 핸들러를 감싸 경고로 바꿨다.
-- 응답 창 <CR> → 요청 줄이 이미 지워져 범위 밖일 때 E5108 로 죽는 것을 막는다
do
  local ui = require('kulala.ui')
  local orig = ui.keymap_enter
  ui.keymap_enter = function(...)
    local ok, err = pcall(orig, ...)
    if not ok then
      if tostring(err):find('Invalid cursor line', 1, true) then
        vim.notify('kulala: 요청 위치가 바뀌어 이동할 수 없음 (.http 파일이 수정됨)', vim.log.levels.WARN)
      else
        error(err, 0)
      end
    end
  end
end
다른 오류는 그대로 올려 보내야 하므로 문자열을 확인하고 아닌 것은 error(err, 0)로 재전파한다. 이 상황을 재현해 경고로 바뀌는 것까지 확인했다.
변수 — 쓸 만한 것과, 따옴표가 부르는 400
.http 파일은 변수를 여러 층으로 받는다. 파일 안에서 @name = 값으로 정의해 {{name}}으로 쓰고, 환경별 값은 http-client.env.json(기본 dev, 상위 폴더와 병합)에 두고, 비밀값은 git에서 뺀 http-client.private.env.json이나 .env·시스템 환경변수로 분리한다. ### 이름으로 요청에 이름을 붙이면 다음 요청에서 {{이름.response.body.$.json.token}}처럼 이전 응답 값을 그대로 참조할 수 있고, {{$uuid}} {{$timestamp}} {{$date}} {{$randomInt}} 같은 내장 변수도 있다.
httpbin.org로 세 요청을 만들어 run_all로 돌려 환경 변수·private 변수·$uuid·응답 참조가 모두 동작하는 것을 확인했다. 로그인 요청에서 만든 $uuid 토큰과 다음 요청의 Bearer 값이 정확히 일치했다. # @prompt/# @secret 입력과 prod 환경 전환은 검증하지 않았다.
여기서 처음 막힌 게 변수에 따옴표를 넣은 경우다.
@content="JEV 모델 동향 조사"
이렇게 정의하면 따옴표가 값의 일부가 된다. 본문에서 "content":"{{content}}"처럼 한 번 더 감싸면 ""JEV 모델 동향 조사""가 되어 JSON이 깨진다.
{"error":{"message":"request body is not valid JSON","type":"invalid_request_error","param":null,"code":"invalid_json"}}
따옴표는 JSON 쪽에만 두고 변수는 맨값으로 정의한다.
@content=홍길동입니다. 이메일은 hong@example.com 입니다
같은 이름을 파일 안에서 두 번 정의하면 마지막 값이 쓰인다. 위쪽 정의를 고쳤는데 결과가 그대로라면 아래에 같은 이름이 또 있는지 본다.
labels는 42개 고정 enum이다
따옴표를 고치고 나니 이번엔 422가 떴다.
{"error":{"message":"invalid extraction request; check model, messages, labels and parameters"}}
문제는 labels에 넣은 값이었다. 이 모델의 labels는 자유 문자열이 아니라 고정된 42개 중에서 고르는 enum이다. API reference의 스키마가 그렇게 적고 있다.
원문 근거
"Required nonempty subset of the 42 supported PII labels; duplicates are rejected."
모델 소개 페이지의 설명과도 맞는다.
원문 근거
"detects personally identifiable information (PII) in text across 42 entity types and seven languages."
처음 요청에 넣었던 occupation, religious_belief, political_view, language는 넷 다 목록에 없다. 그리고 목록 밖 값이 하나만 섞여도 요청 전체가 거부된다. 라벨을 하나씩 따로 보내 보면 email·person·full_name·phone_number·first_name·last_name·country·city는 200, 위 넷은 422로 갈린다.
가장 번거로운 점은 응답이 어느 라벨 때문인지 알려 주지 않는다는 것이다. 본문은 위 한 줄이 전부이고 허용 목록도 들어 있지 않다. 그래서 목록은 API reference에서 직접 봐야 한다. 2026년 11월 23일 기준 42개는 다음과 같다.
access_token, account_id, account_number, address, api_key, bank_account,
card_cvv, card_expiry, card_number, city, country, date_of_birth,
document_date, drivers_license_number, email, expiration_date, first_name,
full_name, government_id, iban, ip_address, last_name, license_number,
middle_name, national_id_number, passport_number, password, payment_card,
person, phone_number, postal_code, recovery_code, routing_number, secret,
sensitive_account_id, sensitive_date, state_or_region, street_address,
tax_id, tax_number, transaction_date, username
배열 제약은 minItems 1, maxItems 42이고 요청 객체에 additionalProperties: false가 걸려 있어 스키마에 없는 필드를 얹어도 거부된다.
그런데 같은 문서의 예시 요청 본문은 이렇다.
{
  "text": "Email jane@example.com.",
  "pii_labels": "email",
  "threshold": 0.3
}
text와 pii_labels는 그 문서 자신의 스키마에 없는 필드다. 필수 필드는 model·messages·labels이고 additionalProperties: false이므로, 이 예시를 그대로 붙여 넣으면 스키마상 통과할 수 없다. 문서는 이 모순을 설명하지 않는다. 예시 말고 스키마를 보고 쓰면 된다.
동작한 요청은 이런 모양이다.
@content=홍길동입니다. 이메일은 hong@example.com 입니다

### GLiNER PII

POST https://integrate.api.nvidia.com/v1/chat/completions
Authorization: Bearer {{NVIDIA_API_KEY}}
Content-Type: application/json

{
    "model": "fastino/gliner2-pii",
    "messages": [{"role":"user","content":"{{content}}"}],
    "labels": ["person","email","phone_number","country","city"],
    "threshold": 0.4,
    "chunk_length": 384,
    "overlap": 128,
    "flat_ner": false
}
messages를 쓰지만 마지막 메시지만 분석한다는 점은 알고 있어야 한다. 대화 맥락을 쌓아 보내도 앞 메시지는 보지 않는다. 분석 한도는 16,384자, 128청크다. 기본값은 threshold 0.3, chunk_length 384, overlap 128, flat_ner false다.
문서는 아직 “출시 예정”이라고 적혀 있다
모델 카탈로그 페이지는 지금도 호스티드 API를 계획 단계로 적고 있다.
원문 근거
"For the planned production API, send a `POST` request to the NVIDIA API endpoint ... with "model": "fastino/gliner2-pii" in the request body."
출시 표기도 Build.NVIDIA.com: 11/16/2026 (planned)이고, 페이지 갱신일이 11월 20일인데도 “planned” 그대로다. 그런데 실제로 호출하면 200이 돌아온다. 문서가 상태를 따라오지 못한 것으로 보인다. 되는지 안 되는지는 페이지가 아니라 요청 한 번으로 확인하는 편이 빠르다.
반대 방향도 있다. 구형 모델 nvidia/gliner-pii는 카탈로그 페이지가 멀쩡히 열려 있고 EOL 문구가 한 줄도 없는데(페이지 갱신일 2026-03-03), 같은 엔드포인트로 호출하면 410이 돌아온다. 2026년 11월 22일 호출 기록이다.
{"type":"about:blank","title":"Gone","status":410,"detail":"The model 'nvidia/gliner-pii' has reached its end of life on 2026-07-27T00:00:00Z and is no longer available."}
같은 키로 /v1/models를 받아 보면 목록에 fastino/gliner2-pii는 있고 nvidia/gliner-pii는 없다. 카탈로그 페이지와 실제 엔드포인트는 서로 다른 것을 말하고 있다 — 양쪽 방향 모두.
응답은 JSON 문자열을 한 겹 더 쓰고 있다
응답은 OpenAI chat.completion 형태로 온다. 엔티티는 choices[0].message.content에 들어 있는데, 그 값이 객체가 아니라 JSON 문자열이다. 한 번 더 파싱해야 한다.
원문 근거
"JSON-encoded ExtractionResult; parse this string to obtain entities."
파싱하면 entities 배열이 나오고 각 항목은 text·label·start·end·score를 반드시 갖는다. 오프셋 규칙이 중요하다.
원문 근거
"Offsets are zero-based Unicode character indices into the original analyzed text, with exclusive end."
바이트가 아니라 유니코드 문자 인덱스이고 끝은 미포함이다. 한국어를 다룰 때 이 구분을 놓치면 마스킹 위치가 어긋난다. 파이썬 문자열 슬라이싱과는 그대로 맞는다.
한국어 이름은 범위가 넓게 잡힌다
가상 이름으로 만든 여섯 문장을 threshold 0.3으로 돌려 봤다. 표본이 작아 통계적 결론은 아니다. 경향만 적는다.
| 입력 | 잡힌 범위 | 문제 |
|---|---|---|
| 김민준 대리가 | 김민준 대리가 |
직함 + 조사까지 포함 |
| 박지훈 과장과 | 박지훈 과장과 |
직함 + 조사까지 포함 |
| 홍길동입니다. | 홍길동입니다 |
서술어까지 포함 |
| Kim Minjun | Kim Minjun |
경계 정확 |
이름 자체를 놓치지는 않았다. 문제는 경계다. 영문 이름은 정확한데 한국어만 직함·조사·서술어를 끌어안는다. first_name/last_name도 한국어에서는 신뢰하기 어려웠다 — 대리가, 사원이를 last_name으로 분류하는 식이다. person이 가장 안정적이었다. 문맥 없는 짧은 문장(홍길동입니다.)은 점수가 낮고 아예 city나 street_address로 빠지기도 했다.
모델 카드를 보면 짐작이 간다. 학습 데이터는 합성 텍스트 4,910개이고 언어는 영어·프랑스어·스페인어·독일어·이탈리아어·포르투갈어·네덜란드어 일곱 개다. 한국어는 없다. 교착어의 조사가 이름에 붙어 한 덩어리로 보이는 상황을 학습하지 않았다는 뜻이다. 벤더 스스로도 이름의 과잉 탐지를 적어 뒀다.
원문 근거
"The vendor reports over-prediction of names, including confusion with common nouns, organizations, and products."
다만 “한국어가 학습 데이터에 없어서 범위가 넓어졌다”는 것은 증명된 인과가 아니다. 모델 카드가 예고한 경향과 여섯 문장의 관찰이 일치한다는 정도다. 평가 평균 F1도 벤더 보고치로 0.477이다.
post-request 스크립트로 후처리를 붙인다
범위가 일정한 방향(뒤로 넘침)으로 틀리므로 잘라내는 쪽은 규칙으로 쓸 수 있다. kulala는 요청 블록 끝에 > ./파일.lua 한 줄을 두면 응답 직후 그 스크립트를 실행한다. 원문과 응답을 파이썬 후처리로 넘기고 결과를 로그와 전역 변수에 남기게 했다.
local dir = vim.fs.dirname(response.file)
local ok_req, req = pcall(vim.json.decode, request.body or '')
if not ok_req or not req or not req.messages then
  return client.log('pii_post: 요청 본문을 JSON 으로 읽지 못함')
end
local text = req.messages[#req.messages].content
if not text or vim.islist(text) then return client.log('pii_post: 분석 대상이 문자열이 아님') end

local payload = vim.json.encode({ text = text, response = response.json })
local r = vim.system({ 'python', '-X', 'utf8', dir .. '/pii_postprocess.py' }, { stdin = payload, text = true }):wait()
if r.code ~= 0 then
  return client.log('pii_post: python 실패(' .. r.code .. ') ' .. (r.stderr or ''))
end

local out = vim.json.decode(r.stdout)
client.global.pii_entities = out.entities
client.global.pii_masked = out.masked
client.log('PII 마스킹: ' .. out.masked)
messages[#messages]로 마지막 메시지를 집는 것은 앞서 본 “마지막 메시지만 분석한다”와 같은 규칙을 맞춘 것이다. 원본 응답 본문은 건드리지 않고 로그와 client.global에만 결과를 남긴다.
함정 하나. 이 스크립트 환경에서는 전역 type()을 부를 수 없다. 문자열로 덮여 있어서 attempt to call global 'type'이 난다. 그래서 타입 검사를 vim.islist로 대체했다. v5.3.4에서 확인한 동작이다.
파이썬 쪽은 표준 라이브러리만 쓴다. 이름 라벨의 범위에서 직함과 조사·서술어를 떼어 오프셋을 보정한다.
NAME_LABELS = {"person", "full_name", "first_name", "last_name", "middle_name"}
SUFFIX_MULTI = sorted(["입니다만","입니다","이에요","예요","이었다","이다","이며","이고",
                       "인데","에게서","에게","에서","한테","께서","이랑","으로","부터",
                       "까지","처럼","보다"], key=len, reverse=True)
SUFFIX_SAFE1  = ("는","를","과","와","의","도","만","께")   # 토큰 3글자 이상일 때만 뗀다
SUFFIX_AMBIG  = ("은","이","가","을")                      # 토큰 4글자 이상일 때만 뗀다

def strip_suffix(token):
    for s in SUFFIX_MULTI:
        if token.endswith(s) and len(token) - len(s) >= 2: return token[:-len(s)]
    for s in SUFFIX_SAFE1:
        if token.endswith(s) and len(token) >= 3: return token[:-1]
    for s in SUFFIX_AMBIG:
        if token.endswith(s) and len(token) >= 4: return token[:-1]
    return token
SUFFIX_AMBIG를 따로 둔 이유가 이 코드의 핵심이다. 은·이·가·을은 조사이기도 하지만 이름의 끝 글자이기도 하다. 한가은에서 은을 떼면 이름이 망가진다. 그래서 글자 수로 선을 긋는다 — 세 글자 이름은 건드리지 않고, 네 글자 이상일 때만 뗀다. 그래도 남궁이 같은 네 글자 이름은 잘릴 수 있다. 규칙으로 완전히 가를 수 없는 구간이다.
범위를 다듬는 쪽은 토큰 단위로 앞뒤를 자른다.
def trim_name_span(text, start, end):
    span = text[start:end]
    if not re.search(r"[가-힣]", span): return start, end      # 영문 이름은 그대로 둔다
    toks = [(m.start() + start, m.group()) for m in re.finditer(r"\S+", span)]
    while toks and is_title_token(toks[0][1]): toks.pop(0)      # 앞쪽 직함 제거
    for i, (_, tok) in enumerate(toks):                          # 첫 직함 토큰부터 뒤를 자름
        if is_title_token(tok): toks = toks[:i]; break
    if not toks: return None
    s0, _ = toks[0]; sl, last = toks[-1]
    last = strip_attached_title(strip_suffix(last))              # "김민준대리가" -> "김민준"
    return (s0, sl + len(last)) if last else None
한글이 없으면 손대지 않는다 — 영문 이름은 이미 경계가 정확하므로 건드릴 이유가 없다. 직함 목록(사원·대리·과장·팀장·님·씨 등)은 직접 정한 휴리스틱이지 모델이나 문서에서 온 것이 아니다. 이후 같은 범위에 겹쳐 잡힌 항목(person과 full_name이 같은 구간을 가리키는 경우)은 최고 점수 하나로 합치고, 뒤에서부터 [label]로 치환해 마스킹한다. 뒤에서부터 바꾸는 것은 앞쪽을 먼저 치환하면 뒤쪽 오프셋이 밀리기 때문이다.
단위 테스트 9개가 보장하는 범위는 이렇다 — 직함+조사 절단(김민준 대리가 → 김민준), 서술어 절단(홍길동입니다 → 홍길동), 붙여 쓴 직함(김민준대리가, 이서연씨는), 앞에 붙은 직함(대리 김민준), 자르면 안 되는 이름 보존(이서연·남궁민수·한가은), 영문 미변경(Kim Minjun), 직함만 있는 범위 제외(대리인이), 중복 범위 병합과 마스킹.
실제 API 응답 여섯 문장을 전후 비교하면 이름만 남는다.
입력   고객명 박지훈 과장과 최수아 사원이 연락처 010-1234-5678, 홍길동입니다
결과   고객명 [person] 과장과 [person] 사원이 연락처 [phone_number], [city]
남은 한계
이 후처리는 범위 보정이지 교정이 아니다. 위 결과의 마지막 [city]가 그 경계를 보여 준다 — 홍길동입니다를 모델이 city로 분류했으므로 이름 라벨 집합에 들지 않고, 따라서 후처리가 손댈 대상 자체가 아니다. 라벨이 틀린 경우는 규칙으로 고칠 수 없다.
정리하면 지금 상태는 이렇다. 동작을 확인한 것은 설치와 버전 고정, .http 변수(환경 변수·private 변수·$uuid·응답 참조), 요청 실행과 200 응답, post-request 스크립트가 script_post_output에 결과를 남기는 것까지다. 확인하지 않은 것은 # @prompt/# @secret 입력과 prod 환경 전환, 응답 창에서 O로 스크립트 출력을 열어 보는 동작, 그리고 tree-sitter 파서 빌드(C 컴파일러가 없어 구문 강조와 포맷은 여전히 안 된다)다.
한국어 PII를 제대로 다루려면 결국 한국어를 학습한 모델이 필요하다. 지금 방식은 그때까지 쓰는 완화책이고, 직함 목록이 손으로 쓴 휴리스틱이라는 점도 그대로 한계다. 그래도 오프셋 규칙이 명확하고(유니코드 문자 인덱스, 끝 미포함) 후처리를 요청 바로 뒤에 붙일 수 있다는 점 덕분에, 에디터에서 요청 한 번 실행하는 것만으로 원문·엔티티·마스킹 결과를 한자리에서 보게 됐다.
참고
- kulala.nvim — README의 “Kulala License Tokens” 절,
v5.3.4·v6.0.0릴리스 노트 - build.nvidia.com — fastino/gliner2-pii — 모델 카드(42개 엔티티, 7개 언어, 벤더 보고 한계)
- fastino/gliner2-pii API reference —
labelsenum 42개,ExtractionRequest/Entity스키마, 오프셋 규칙 - Windows에서 Neovim 0.12 설정 다시 짜기 — 이 글이 전제한
vim.pack환경