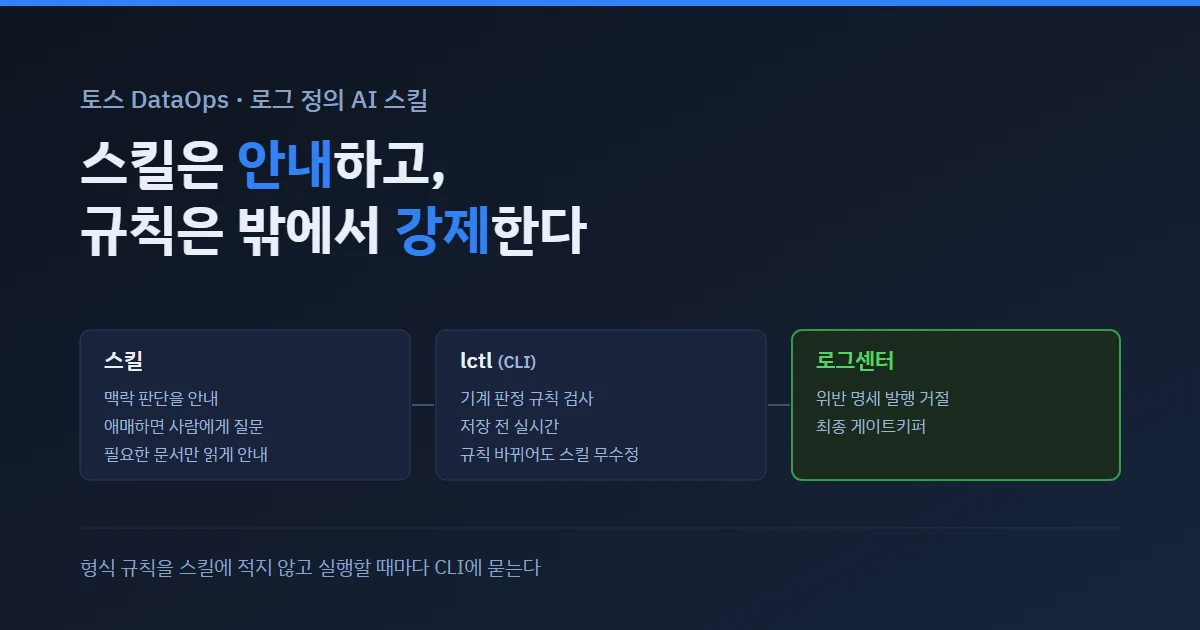
토스, 로그 정의 기준을 AI 스킬로 자동화 — DataOps 매니저가 직접 만든 도구
토스 DataOps 팀이 앱 로그 정의 업무를 AI 스킬로 자동화한 과정을 공유했다. 비개발자인 DataOps Manager(DOM)가 수동으로 진행하던 로그 명세 작성·검증·등록 전 과정을 스킬·CLI·플랫폼이 분업하는 구조로 재설계했고, 개인 도구에서 시작해 팀 전체가 쓰는 표준 도구로 발전시켰다. (이 글의 초안은 설치된 Hermes 에이전트가 작성했고, Claude가 검수 후 발행했다.)
TL;DR: 토스는 로그 정의 업무에 AI 스킬을 도입해 ‘규칙 확인→맥락 조회→명세 제안→CLI 검증→플랫폼 등록’ 전 과정을 자동화했다. 스킬은 판단을 안내하고,
lctl이 형식 규칙을 실시간 검사하며, 로그센터가 위반 명세를 차단한다. 도메인 맥락이 규칙보다 품질을 좌우함을 발견해, 앞으로는 도메인 지식을 지식 베이스로 축적해 스킬이 직접 참조하도록 할 계획이다.
배경: 로그 정의가 힘든 이유
토스 앱에서 발생하는 사용자 행동 로그는 서비스 품질 분석의 기초 데이터다. 로그가 처음부터 정확하고 일관되게 정의되지 않으면 분석 결과도 믿을 수 없다. 이를 위해 토스는 DataOps Manager(DOM) 직군을 두고, 로그 명세를 한곳에서 관리하는 로그센터 플랫폼을 운영한다.
원문이 드는 로그 정의의 네 조건은 이렇다.
- 정해진 형식에 따라서 — 통일된 네이밍·구조 규칙
- 도메인 안의 맥락을 이어서 — 그 도메인이 이미 쌓아 온 정의와 어긋나지 않게
- 분석에 필요한 것만 남기면서 — 쓰지 않을 속성을 붙이지 않는다
- 정책과 안전을 지켜서 — 수집해서는 안 되는 것을 걸러낸다
원문 근거
"로그를 정의할 때에는 로그를 정해진 형식에 따라서, 도메인 안의 맥락을 이어서, 분석에 필요한 것만 남기면서, 정책과 안전을 지켜서 정의해야 해요."
문제는 규칙은 문서(‘앱로그 백과사전’)에 정리돼 있지만, 도메인 맥락은 담당 DOM의 머릿속에만 있다는 점이다. 기존 명세 검색은 가능하지만, 맥락까지 고려해 일관되게 정의하려면 개인의 경험과 기억에 의존할 수밖에 없었다.
AI 스킬로 옮긴 로그 정의 프로세스
한 DOM이 자신의 경험을 담아 만든 개인용 스킬에서 시작해, 누가 어떤 도메인에서 작업하든 쓸 수 있는 팀 표준 스킬로 확장했다. 이 스킬은 로그 명세를 ‘대신 찍어내는 생성기’가 아니다. 다음 순서로 판단을 안내한다.
원문 근거
"새 로그를 만들기 전에 '앱로그 백과사전'의 표준을 확인하고 도메인의 기존 로그 명세를 끝까지 조회해 재사용할 수 있는지 먼저 살피고, 실제 반영은 사람이 확정한 뒤에만 실행해요."
스킬 실행 흐름
- 규칙 확인 — ‘앱로그 백과사전’ 표준 조회
- 기존 명세 조회 — 로그센터에서 동일/유사 도메인 기정의 로그 전체 스캔
- 재사용 후보 제안 — 기존 명세 중 재사용 가능한 것 추천
- 신규 명세 초안 — 규칙·맥락·재사용 후보를 종합해 초안 제시
- 사람 확정 — DOM이 검토·수정 후 확정
- CLI 검증·등록 —
lctl로 형식 규칙 검사 통과 시 로그센터 반영
역할 분담: 스킬·CLI·플랫폼 3계층
| 계층 | 도구 | 역할 |
|---|---|---|
| 판단·안내 | 로그 정의 스킬 | 맥락에 따른 판단 안내, 불확실한 부분은 사람에게 질문, 작업별 필요 문서만 찾아 읽도록 내비게이션 제공 |
| 형식 검증 | lctl (로그센터 CLI) |
로그 이름 형식 등 기계 판정 가능 규칙을 저장 전 실시간 검사, 규칙 변경 시 스킬 수정 없이 최신 기준 자동 적용 |
| 강제·거부 | 로그센터 | 규칙 위반 명세의 발행 거절, 최종 게이트키퍼 |
원문 근거
"로그 이름 형식처럼 기계가 판정할 수 있는 규칙은 `lctl`이 저장 전에 검사하고, 로그센터는 규칙에 맞지 않는 명세의 발행을 거절해요. 형식 규칙은 스킬에 적어두지 않고 실행할 때마다 `lctl`에 묻기 때문에, 규칙이 바뀌어도 스킬은 늘 최신 기준을 따를 수 있어요."
핵심 설계 원칙: 형식 규칙은 스킬에 하드코딩하지 않고, 실행 시점마다 lctl에 위임한다. 이렇게 하면 규칙이 바뀌어도 스킬을 고칠 필요가 없다.
문서 구조 개선: 긴 문서 → 작업별 분할
처음엔 규칙과 절차를 한 문서에 담았으나, 문서가 길어질수록 AI가 중요한 규칙을 놓쳤다. 프론트엔드 개발자 기술 검토를 거쳐 작업별로 문서를 분할하고, 스킬에는 ‘해당 작업에 필요한 문서만 찾아가는 안내’만 남겼다. 이제 AI는 매번 긴 문서를 읽지 않고, 현재 작업에 필요한 조각만 읽는다.
일하는 방식의 변화: 업무 당사자가 직접 도구 만들기
기존에는 업무 도구 개선 시 실사용자가 기획 과정에 맥락을 전달하고, 플랫폼 조직이 개발했다. 이번에는 업무를 가장 잘 아는 DOM이 AI를 활용해 직접 스킬을 만들었고, 플랫폼 조직(로그 프로덕트팀)은 검토 후 lctl에 통합·배포만 맡았다.
원문 근거
"이번 기회로 일하는 방식도 달라졌어요. 기존에는 업무 도구를 개선할 때, 실사용자로서 필요한 기능과 업무 맥락을 기획 과정에 전달했어요. 하지만 이번에는 그 맥락을 가장 잘 아는 저희가 AI를 활용해 필요한 도구를 직접 만들었어요."
평가와 발견: 규칙보다 ‘도메인 맥락’이 품질을 좌우
각자 맡은 도메인의 기정의 로그 명세를 정답지로 두고, 같은 화면을 스킬로 다시 정의해 비교하는 평가를 반복했다. 평가할수록 분명해진 사실: 정의의 품질을 좌우하는 건 규칙이 아니라 도메인의 맥락이다.
평가에서 걸린 문제와 그에 대한 처방이 구체적이다.
| 발견한 문제 | 적용한 해결 |
|---|---|
| 기존 로그를 찾기 어렵다 | 카테고리 기반 추론 |
| 도메인마다 이름이 제각각이다 | 유사 이름 검사 |
| 도메인 지식이 관리되지 않는다 | 표준 도메인 입력 방식 + 맥락 추가 |
앞으로는 도메인별 로그 이름·파라미터 의미·그렇게 정한 이유를 지식 베이스로 축적해, 스킬이 로그 정의 전에 이를 먼저 읽게 할 계획이다. 이를 통해 복잡한 유저 플로우 로그도 더 정확하고 일관되게 정의할 수 있을 것으로 기대한다.
시사점: AI 스킬 설계에 참고할 점
이 사례는 에이전트/스킬 기반 자동화를 개발 환경에 도입할 때 참고할 만한 패턴을 보여준다.
- 생성기 vs 안내자: 스킬이 ‘결과물을 찍어내는 것’이 아니라 ‘판단 과정을 안내하고 사람 확정을 받는’ 역할로 설계됐다. 사람이 개입할 지점을 명시적으로 둔 것이다.
- 검증 분리: 형식 규칙 검증(CLI)과 비즈니스 규칙 강제(플랫폼)를 스킬 밖으로 분리했다. 스킬은 최신 규칙을 매번 외부에서 조회하므로 유지보수 부담이 줄고, 규칙 변경 시 스킬 재배포 없이도 동작한다.
- 문서 청킹: 긴 가이드 문서를 작업 단위로 쪼개고, 스킬이 필요할 때만 해당 조각을 읽게 하면 컨텍스트 윈도우 압박과 환각을 동시에 줄일 수 있다.
- 도메인 지식 베이스: 규칙(정형)보다 맥락(비정형)이 품질을 가른다. 도메인 지식을 구조화해 스킬이 참조하게 하는 방향이 장기적으로 더 효과적이다.
- 당사자 주도 개발: 업무를 아는 사람이 직접 스킬을 만들고, 플랫폼 조직은 런타임·배포·거버넌스만 담당하는 ‘시민 개발자’ 모델이 검증됐다.
참고 자료
- 토스 기술 블로그 원문 — 머릿속에 있던 로그 정의 기준을 모두의 AI 스킬로 만들기
- 토스
lctlCLI / 로그센터 플랫폼 (사내 도구, 공개 저장소 없음)