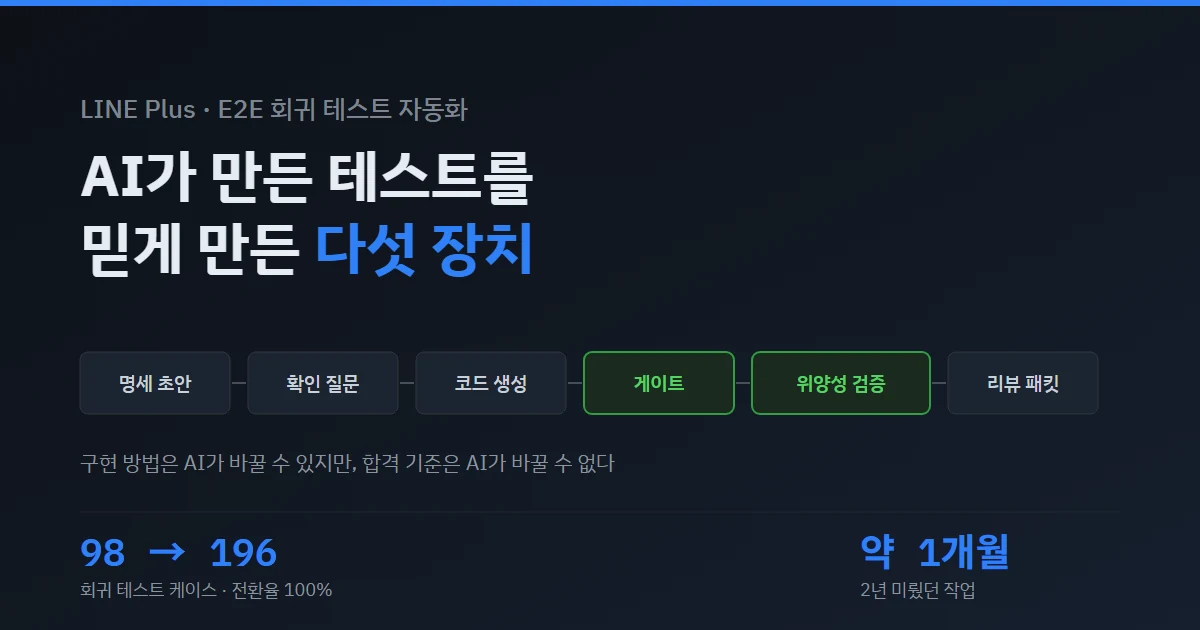
AI가 만든 테스트를 믿는 법 — LINE Plus가 회귀 테스트를 98개에서 196개로 늘린 다섯 장치
AI에 테스트 케이스를 넘기면 Playwright 코드는 나온다. 진짜 문제는 그다음이다 — 그 테스트가 통과했다고 해서, 내가 검증하려던 것을 검증했다는 뜻은 아니다. LINE Plus의 대만 Giftshop QA 김혜영 님이 이 함정에 걸린 뒤 파이프라인을 다시 짠 기록을 정리한다. AI에게 산출물을 맡기는 모든 작업에 그대로 옮겨 붙는 이야기다. (이 글의 초안은 설치된 Hermes 에이전트가 작성했고, Claude가 검수 후 발행했다.)
TL;DR: v1.0은 코드를 잘 만들었지만
.first()한 줄로 엉뚱한 컨테이너를 검증하고도 PASS를 냈다. v2.0은 실행 전 게이트와 기댓값을 일부러 틀리게 바꿔 보는 위양성 검증을 넣어 이를 막았다. 원칙은 하나다 — 구현 방법은 AI가 바꿔도 되지만 합격 기준은 바꿀 수 없다. 결과는 회귀 테스트 98개 → 196개, 자동화 전환율 100%, 구축 기간 약 한 달.
처음엔 ‘딸깍’인 줄 알았다
출발은 흔한 기대였다. 이미 사람이 정리해 둔 자동화 테스트 케이스를 AI에 넘기면 Playwright 코드가 알아서 나오고, 몇 번 다듬으면 끝날 것 같았다.
v1.0 파이프라인은 다섯 단계였다. ① 테스트 케이스를 읽어 시나리오·스텝·기대 결과로 구조화 ② 실제 브라우저에서 locator 검증·보정 ③ 코드 생성 ④ 실행 ⑤ 리포팅.
원문 근거
"각 단계는 JSON 파일로 연결해 문제가 생긴 단계만 다시 실행할 수 있도록 했습니다. 규칙으로 처리할 수 있는 작업은 코드로 처리하고, 모호한 판단은 AI에 맡기는 방식이었습니다."
단계 사이를 JSON으로 잇는 설계는 그대로 가져다 쓸 만하다. 실패한 단계만 다시 돌릴 수 있어 전체 재실행 비용이 사라진다.
코드는 빠르게 나왔다. 그런데 리뷰하다 보니 테스트는 통과하는데 엉뚱한 것을 보고 있었다.
통과했는데 틀린 두 가지 방식
유형 1 — 컨테이너가 여러 개인데 확인 없이 첫 번째를 골랐다. 홈 화면에 .announcement_list.is_home 클래스를 쓰는 영역이 둘 있었다. 공지 영역과 광고 계획 영역이 같은 클래스를 공유한 것이다. 원본 의도는 두 번째였는데, 파이프라인은 여러 개를 발견하자 .first()를 붙였다.
// NOTE: Multiple containers found (2), using first
const container = page.locator('.announcement_list.is_home').first();
const items = container.locator('.announcement_item');
원문 근거
"코드는 정상적으로 실행됐고 테스트도 통과했습니다. 문제는 제가 검증하려던 광고 계획(廣告方案) 이 아니라 첫 번째 컨테이너인 공지(通知) 영역을 확인했다는 점입니다."
주석까지 친절하게 남겼다는 게 오히려 무섭다. 어느 쪽이 맞는지에 대한 판단이 .first() 한 줄에 묻혔다.
유형 2 — 여섯 개를 검증해야 하는데 하나만 보고 통과시켰다. 오늘 판매 현황 영역의 6개 항목을 모두 확인하는 테스트였는데, 생성된 코드에는 첫 항목만 남았다.
원문 근거
"6개 중 하나만 확인했지만 테스트는 정상적으로 통과했습니다. 원본 테스트 케이스에 있던 검증 항목이 코드로 바뀌는 과정에서 사라진 것입니다."
두 사례의 공통점은 모호할 때 파이프라인이 멈추지 않았다는 것이다. 어떻게든 실행 가능한 코드를 만들었고, 실행에 성공하면 PASS로 처리했다.
v2.0의 원칙
목표를 바꿨다. AI가 테스트를 얼마나 많이 만드는지가 아니라, AI가 만든 결과를 사람이 얼마나 빨리 확인하고 믿을 수 있는지를 기준으로 삼았다.
원문 근거
"v2.0의 원칙은 ‘구현 방법은 AI가 바꿀 수 있지만, 합격 기준은 AI가 바꿀 수 없다’로 정리할 수 있습니다."
역할을 셋으로 쪼갠 표가 이 글의 핵심이다.
| 누가 | 무엇을 |
|---|---|
| AI가 자유롭게 바꾼다 | locator 선택, 코드 구조, 대기 방식 |
| 코드로 고정해 못 바꾼다 | 기대 결과, assertion 존재, test.only·test.fixme·test.skip·waitForTimeout·networkidle 금지 |
| 끝까지 사람이 판단한다 | locator가 맞는 요소인지, 원래 의도를 충분히 확인하는지, 제품 버그인지 |
다섯 장치
① 명세 초안 — 기대 결과를 코드까지 추적한다. 테스트 케이스를 바로 코드 생성에 넘기지 않고 구조화된 명세를 먼저 만든다. raw_expected에 원본을 그대로 담고, expected_items로 최소 검증 단위로 쪼개고, assertion에 실제 검증 내용을 정의하고, covers로 둘을 잇는다.
- { id: E2, description: "廣告方案 영역 하위 list 항목이 3개 노출된다" }
- { id: A2, description: "廣告方案 영역 하위 list 항목이 3개다", covers: [E2] }
유형 2처럼 검증이 증발하는 문제를 여기서 잡는다.
② 확인 필요 항목(gap) — 애매하면 추측하지 않고 멈춘다. 결과에 영향을 주는 모호한 지점은 질문으로 남기고, 사람이 답하기 전까지 다음 단계로 가지 않는다. “각 항목 숫자를 특정 값으로 단정해야 하나요, 아니면 존재 여부만 확인해야 하나요?” 같은 질문이다. 이 과정에서 자동화 코드뿐 아니라 원본 테스트 케이스의 오류와 모순도 발견됐다고 한다.
③ 게이트 — 검사를 통과하지 못하면 실행하지 않는다. 코드 생성 후 실행 직전에 돌리는 자동 검사 다섯 개다.
validate-spec                   명세 형식·필수 항목         (차단)
verify-assertion-coverage       명세의 검증 항목이 코드에 다 들어갔는지 (차단)
safety-check                    위험 패턴 없는지            (차단)
gap-scope-lint                  검증 범위가 모호한 항목 잔존  (경고)
expected-decomposition-lint     기대 결과가 빠짐없이 쪼개졌는지 (경고)
safety-check가 막는 패턴 목록이 특히 실용적이다. test.only·test.skip·test.fixme는 실행 결과를 오해하게 만들고, waitForTimeout·networkidle은 테스트를 불안정하게 만든다. 근거를 남긴 예외만 허용한다.
④ 위양성 검증 — 기댓값을 일부러 틀리게 바꿔 본다. 게이트를 통과하고 테스트가 돌았어도, 그 테스트가 실제로 기댓값을 보고 있는지는 별개다. 항목이 3개인지 확인하는 테스트라면 기댓값을 4로 바꿔 본다. 이때 실패해야 정상이다.
원문 근거
"여기서 PASS 는 변경한 테스트가 통과했다는 뜻이 아니라, 기댓값을 변경했을 때 대상 assertion 이 정상적으로 실패해 위양성 검증을 통과했다는 의미입니다."
mutation testing의 아이디어를 assertion 동작 확인에 가져다 쓴 것이다.
⑤ 리뷰 패킷 — 사람이 볼 것만 모아 준다. 실제로 확인된 사실과 AI의 분석을 구분해서 보여 주고, 사람 확인이 필요한 항목을 따로 표시한다. locator가 무엇을 가리켰는지 눈으로 보도록 스크린샷도 남긴다. 유형 1처럼 코드만으로 판단할 수 없는 문제는 게이트로 막는 대신 여기로 넘긴다.
결과
원문 근거
"기존에 수동으로 관리하던 회귀 테스트 케이스는 98개였습니다. ... 최종적으로 회귀 테스트 케이스 수를 98개에서 196개까지 늘렸습니다."
- 수동 회귀 테스트 케이스 자동화 전환율 100%, 케이스 수 98 → 196개
- 파이프라인 설계·시행착오에 몇 달, 완성 후 실제 테스트 코드 구축은 약 한 달
- 셀러 센터 회귀 테스트 자동화는 2년 가까이 손대지 못하던 일이었다
- CI와 연동해 정해진 주기로 자동 실행 중
QA 본업을 하면서 코드 생성과 실행은 파이프라인에 맡기고, 시간 날 때 대시보드에서 판단할 부분만 봤다는 대목이 이 수치의 맥락이다.
한계도 분명하다
첫째, 선행 비용이 크다. 명세 구조·게이트·위양성 검증·리뷰 패킷을 직접 설계해야 한다. 짧게 쓰고 버릴 자동화라면 오히려 일이 커진다. 오래 유지할 회귀 테스트였기에 값어치가 있었다.
둘째, 사람 판단은 남는다. locator가 의도한 요소를 가리키는지, assertion이 원래 의도를 충분히 확인하는지는 여전히 사람 몫이다.
셋째, 위양성 검증이 만능이 아니다. 개수·텍스트·URL처럼 기댓값을 명확히 바꿀 수 있는 검증에만 통한다. 단순 노출 검증은 자동으로 확인하기 어려워 사람 리뷰로 넘겼다.
그리고 아직 셀러 센터 한 서비스에서만 검증된 단계다. 다른 서비스로 넓히며 공통 영역을 분리하는 것이 다음 목표라고 한다.
원문 근거
"결국 이 워크플로는 사람을 없애는 자동화가 아닙니다. 사람이 직접 판단해야 할 부분을 줄이고, 어디를 봐야 하는지 분명하게 만드는 자동화에 가깝습니다."
테스트 밖으로 가져갈 것
이 글은 E2E 테스트 이야기지만, 구조는 AI에게 산출물을 맡기는 모든 파이프라인에 그대로 적용된다.
- 생성물이 아니라 생성물의 검증 장치에 투자한다. 코드를 더 잘 뽑는 프롬프트보다, 틀렸을 때 멈추는 게이트가 수익률이 높다
- 모호하면 멈추고 묻게 만든다. AI가 조용히 결정해 버리는 지점이 나중에 가장 비싼 버그가 된다
- 검증 장치 자체를 검증한다. 위양성 검증이 그 역할이다. “통과했다”는 신호가 실제로 무언가를 보고 있는지 확인하는 장치가 없으면, 통과율은 아무 의미가 없다
- 금지 패턴을 코드로 고정한다.
test.only·waitForTimeout같은 목록은 사람이 리뷰로 잡으려 하면 반드시 샌다
참고
- AI로 E2E 회귀 테스트 자동화하기: ‘딸깍’을 파이프라인으로 바꾸기까지 — LY Corporation Tech Blog (김혜영, LINE Plus Global E-Commerce QA)
- Playwright 공식 문서