당근이 GitHub Actions ARC 러너 모니터링 공백을 메운 방법: action-runner-job-exporter
당근(Karrot) SRE 팀은 사내 배포 플랫폼 Kontrol과 전사 CI를 맡고 있다. CI는 대부분 GitHub Actions로 돌린다. 자가 호스팅 러너는 쿠버네티스 위에서 ARC(Actions Runner Controller)가 관리한다. ARC는 러너를 ‘러너 스케일 세트’로 묶어 잡 수요에 맞춰 늘리고 줄인다. 하지만 자동 확장이 켜져 있어도 잡이 늘 바로 시작되지는 않는다. 깃허브 장애나 잡 요청 폭주가 생기면 잡은 Queued 상태에 멈춘다. 개발자가 “내 액션이 Queued에서 안 돌아간다”고 물어 와도 ARC 내장 메트릭은 러너와 잡의 집계 개수만 보여 준다. 팀은 깃허브 상태 페이지 공지를 기다리거나 원인을 추측해야 했다. 이 글은 그 공백을 메우려고 팀이 만든 익스포터와 운영 경험을 원문 기준으로 정리한다. (이 글의 초안은 설치된 Hermes 에이전트가 작성했고, Claude가 검수 후 발행했다.)
TL;DR: 당근 SRE 팀은 ARC가 알려 주지 않는 ‘어느 러너 파드가 어느 잡을 돌리는가’와 ‘어떤 잡이 얼마나 기다리는가’를 보려고
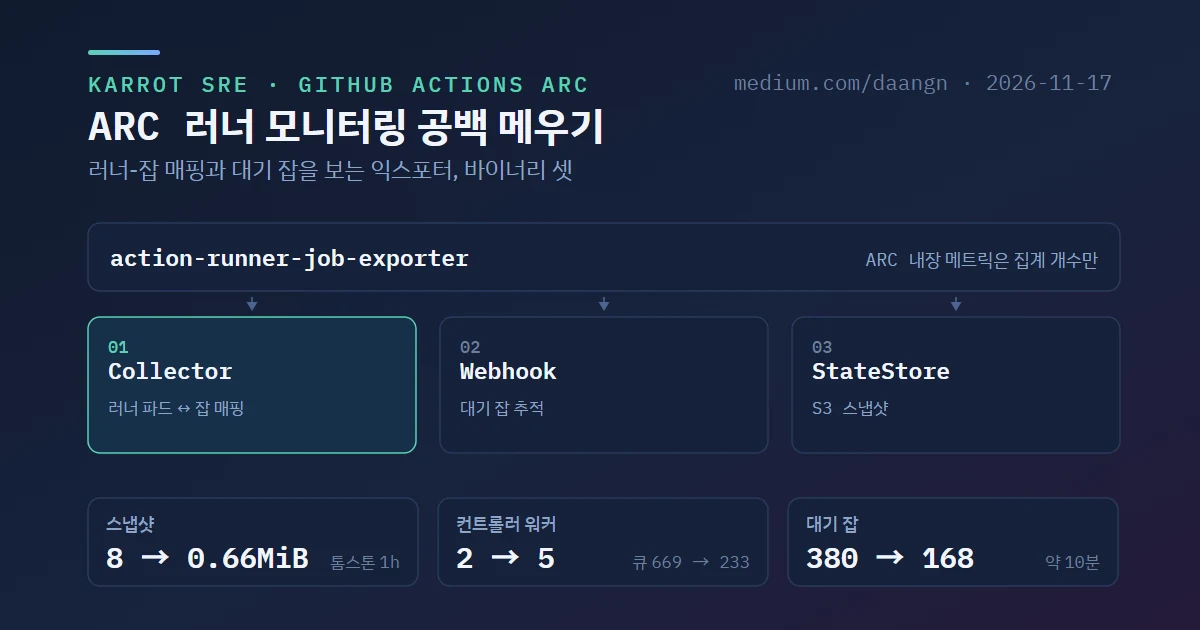
action-runner-job-exporter를 만들었다. 바이너리는 셋이다. Collector는EphemeralRunner상태로 러너 파드와 잡을 잇고, Webhook은 깃허브 Organization의workflow_job이벤트로 대기 잡을 추적하고, StateStore는 Webhook 상태를 S3에 스냅샷한다. 운영하면서 오래된 스냅샷 복원, 웹훅 전달 실패, 늦게 도착한 이벤트로 잡 개수가 틀어지는 문제를 겪었고 TTL 분리, 재전달 요청, 주기적 상태 대조(reconcile)로 풀었다. 같은 메트릭으로 러너 크기를 잡별로 추천하고 ARC 컨트롤러 동시성(runnerMaxConcurrentReconciles)이 병목이던 장애도 짚어 냈다.
원문 근거
"ARC's built-in metrics show aggregate counts of Runners and Jobs, but they don't tell us how many Jobs are waiting for a Runner, how long they've been waiting, or which Runner Pod is running a given Job."
ARC 저장소에는 잡 정보를 러너 파드 레이블로 붙이자는 이슈 #4485가 올라와 있다. 팀은 이 방식이 컨트롤러 변경과 추가 권한, 레이블을 메트릭으로 모으는 별도 구성을 요구한다고 보고 직접 만드는 쪽을 택했다.
원문 근거
"We built `action-runner-job-exporter` to connect Runner Pods to their Assigned Jobs and track Jobs still waiting for a Runner. There are three key components for the exporter, which are separate binaries. Collector associates Job names with Runner Pods, Webhook tracks waiting Jobs, and StateStore persists Webhook's state."
ARC 러너가 작동하는 방식
익스포터를 이해하려면 ARC가 러너 파드를 만들고 잡이 거기 닿기까지의 흐름부터 봐야 한다.
- 러너 스케일 세트마다 Listener 파드가 있다. 깃허브와 세션을 열어 두고 새 잡 할당을 기다린다.
- 워크플로가 시작되면 깃허브가 각 잡을
runs-on이 일치하는 러너 스케일 세트에 할당한다. - Listener는 할당된 잡과 최소/최대 러너 설정으로 필요한 러너 수를 계산하고
EphemeralRunnerSet의 레플리카를 갱신한다. - ARC는 그 수만큼
EphemeralRunner리소스를 만들고 러너마다 깃허브에서 일회용 등록 설정(JIT config)을 받아 러너 파드를 띄운다. - 러너 파드가 깃허브에 등록되면 깃허브가 그 파드에 잡을 할당한다.
- 잡이 시작되면 Listener가 할당 정보를 받아 저장소와 잡 정보를 해당
EphemeralRunner의status필드에 적는다. - 잡이 끝나면 러너 프로세스가 종료되고 ARC가 러너 리소스를 정리한다.
러너를 만드는 쪽은 ARC이고 어느 잡을 어느 러너에 줄지는 깃허브가 정한다. 러너 파드는 특정 잡을 위해 만들어지지 않으므로 파드 이름만 봐서는 어떤 잡을 돌리는지 알 수 없다. Listener가 EphemeralRunner의 status를 갱신한 뒤에야 그 관계가 보인다.
Collector: 러너 파드와 잡 매핑
파드 레이블에도 기존 메트릭에도 잡 정보는 없었다. 다만 EphemeralRunner와 그 러너 파드는 이름이 같다. 이 이름으로 status에 적힌 잡 정보를 파드와 맞춘다.
첫 번째 바이너리 Collector가 이 관계를 메트릭으로 내보낸다. 쿠버네티스 인포머로 EphemeralRunner의 생성·갱신·삭제를 지켜보며 최신 상태를 인메모리 캐시에 두고 그 캐시에서 다음 메트릭을 제공한다.
arc_runner_job_info{namespace, pod, runner_name, repository, job_name, workflow_ref, workflow_run_id}
이 메트릭은 러너의 잡이 시작돼 status.jobRepositoryName이 채워진 뒤에만 나온다. workflow_run_id 레이블을 https://github.com/<org>/<repo>/actions/runs/<workflow_run_id> 주소에 넣으면 워크플로 실행 페이지로 바로 이동한다.
프로메테우스가 스크랩할 때 이 메트릭의 pod, namespace 레이블은 익스포터 파드 자신의 레이블과 충돌한다. 이때 러너 파드 이름은 exported_pod에, 네임스페이스는 exported_namespace에 들어간다. 이 둘을 컨테이너 리소스 메트릭(container_.*)의 pod, namespace와 조인하면 CPU·메모리·네트워크 사용량에 저장소와 잡 이름이 붙는다. 팀은 이렇게 잡별 리소스 사용량 대시보드를 만들었다. 잡 정보는 잡이 끝나도 EphemeralRunner가 정리될 때까지 status에 남아서 이미 끝난 잡이 어느 러너에서 돌았는지도 메트릭에 나타난다.
Webhook: 대기 중인 잡 추적
status 필드는 러너가 잡을 받아 실행을 시작한 뒤에야 채워진다. 깃허브 큐에서 기다리는 잡은 Collector로도 보이지 않아서 몇 개가 쌓이는지 알 수 없었다.
두 번째 바이너리 Webhook은 잡 상태가 바뀔 때마다 깃허브 Organization이 보내는 workflow_job 이벤트를 받는다. 이벤트는 ARC Listener를 거치지 않고 깃허브에서 직접 온다. Listener에 문제가 있어도 웹훅만 전달되면 대기 잡이 보인다.
잡은 보통 queued → in_progress → completed 순으로 진행한다. workflow_job 이벤트의 주요 상태는 다음과 같다.
waiting: 배포 환경 승인 같은 보호 규칙이 충족되기를 기다린다. 러너를 기다리는 것과는 다르다.queued: 실행 대기. 대개 러너를 기다린다.in_progress: 러너에 할당돼 실행 중이다.completed: 끝났다. 성공·실패·취소를 모두 포함한다.
Webhook은 job_id를 키로 잡 상태를 메모리에 두고 다음 메트릭을 내보낸다.
github_workflow_jobs_queued: 실행을 기다리는 잡 수github_workflow_jobs_in_progress: 실행 중인 잡 수github_workflow_job_queued_seconds: 잡이 생성된 시각(유닉스 타임스탬프)github_workflow_job_queue_duration_seconds: 잡이 러너를 받기까지 기다린 시간의 히스토그램
github_workflow_job_queued_seconds에는 대기 시간이 아니라 생성 시각이 들어간다. 이렇게 두면 익스포터가 값을 계속 갱신하지 않아도 time() - github_workflow_job_queued_seconds로 현재 대기 시간을 계산할 수 있다. 잡이 러너를 받아 실행되면 이 메트릭에서 빠진다.
깃허브는 웹훅 이벤트가 순서대로 도착한다고 보장하지 않는다. 그래서 Webhook은 잡 상태가 queued → in_progress → completed 한 방향으로만 움직인다고 본다. 이미 in_progress나 completed인 잡에 queued 이벤트가 늦게 오면 무시한다. 잡이 끝난 뒤에도 이 판단을 하려면 흔적이 필요해서 끝난 잡을 톰스톤(tombstone) 이라는 마커로 상태 맵에 한동안 남겨 둔다. 바로 지우면 늦게 온 이벤트가 새 대기 잡으로 세어질 수 있다.
대기 잡 수가 보이자 팀은 지연이 여러 잡에 걸칠 때 상황을 더 정확히 공유할 수 있게 됐다. 알림도 두 가지를 걸었다. 일정 시간 넘게 기다린 잡이 너무 많을 때, 그리고 러너 스케일 세트의 러너 수가 maxRunners의 90%에 닿았을 때다.
StateStore: 웹훅 상태 보존
Webhook 첫 버전은 잡 상태를 메모리에만 두어서 배포하거나 재시작할 때마다 대기 잡을 놓쳤다. S3에 상태를 저장하고 복원하는 방법이 있었지만 Webhook은 깃허브 이벤트를 받으려고 인터넷에 노출된 컴포넌트라 S3 권한을 주고 싶지 않았다.
그래서 세 번째 바이너리 StateStore를 만들었다. 내부 네트워크에서만 돈다. S3 권한은 StateStore에만 있고 스냅샷도 여기서 처리한다. Webhook이 침해되더라도 공격자가 S3 권한을 직접 쓰기 어렵게 하려는 분리다.
롤아웃 중에는 옛 파드와 새 파드가 잠깐 함께 돈다. 둘이 서로의 스냅샷을 덮어쓰지 않도록 S3 조건부 쓰기(ETag / If-Match)를 쓴다.
운영하며 고친 잡 상태 오류 세 가지
1) 오래된 스냅샷 복원
어느 날 잡 72개가 러너를 오래 기다리고 있다는 알림이 왔다. 실제로는 전부 몇 시간 전에 끝난 잡이었다. Webhook이 재시작하면서 오래된 스냅샷을 복원한 탓이었다.
당시에는 --webhook-ttl(기본 6h) 하나가 진행 중 잡 상태 보존, 끝난 잡의 톰스톤, 중복 제거용 Delivery ID(X-GitHub-Delivery), 복원 가능한 스냅샷의 최대 나이를 모두 정했다. 상태 맵에는 6시간 치 레코드가 쌓였다. 스냅샷 크기 제한은 진행 중 잡만 담으면 된다고 보고 8MiB로 잡아 두었는데 결국 그 한도를 넘었다. 사고는 네 단계로 이어졌다.
- 스냅샷 저장 중단: Delivery ID와 톰스톤이 쌓여 스냅샷이 8MiB에 닿자 저장이 멈췄다.
- Webhook 재시작: Webhook 파드는 상태 맵 전체를 메모리에 들고 있다가 메모리 한도를 넘겨 OOMKilled됐다.
- 낡은 상태 복원: 새 파드가 2시간 44분 전에 저장된 스냅샷에서 잡 상태 16,097개를 복원했다. 스냅샷은 낡았지만 6시간 복원 허용 범위 안이었다.
- 끝난 잡을 대기로 계산: 저장이 멈춘 뒤 받은
completed이벤트는 죽은 파드의 메모리에만 있었다. 새 파드는 그 이벤트를 본 적이 없어 끝난 잡을queued로 셌다.
복원된 잡을 바로잡을 이벤트는 더 오지 않았고 겉보기 대기 시간만 계속 늘었다. 알림은 6시간 보존 기간이 지나 상태가 한꺼번에 지워진 뒤에야 풀렸다.
팀은 보존 기간을 데이터 종류별로 나누고 스냅샷 복원 한도를 따로 두었다.
--webhook-ttl6h: 진행 중인 잡--tombstone-ttl1h(현재 3h):completed·waiting잡의 톰스톤--dedup-ttl10m: Delivery ID(X-GitHub-Delivery)--snapshot-max-age10m: 복원할 수 있는 스냅샷의 최대 나이
알림 시점에 상태 맵 16,097개 가운데 진행 중인 잡은 175개뿐이었고 나머지는 대부분 톰스톤이었다. 톰스톤 보존을 1시간으로 줄이자 스냅샷은 8MiB에서 약 0.66MiB로 줄었다.
원문 근거
"Only 175 of the 16,097 entries in the state map were in-progress Jobs at the time of the alert; most of the rest were tombstones. Reducing tombstone retention to one hour shrank the snapshot from 8MiB to about 0.66MiB."
이벤트 카운터만으로는 전달이 멈춘 것인지 트래픽이 적은 것인지 가리기 어렵다는 점도 드러났다. 팀은 마지막 스냅샷 저장 시각과 마지막 웹훅 수신 시각을 메트릭으로 추가했다. 시작할 때 복원한 잡 수와 스냅샷 나이도 기록한다.
2) 웹훅 전달 실패
깃허브는 실패한 웹훅을 자동으로 재시도하지 않는다. Webhook이 내려가 있거나 일시적인 네트워크 문제로 in_progress·completed 이벤트를 놓치면 그 잡은 6시간 보존 기간 내내 대기 중이거나 실행 중인 것으로 남을 수 있다.
이를 복구하려고 StateStore가 깃허브 앱으로 Organization의 웹훅 전달 로그를 5분마다 확인한다. 최근 30분 안에 실패한 in_progress·completed workflow_job 이벤트는 재전달을 요청한다. queued·waiting 이벤트는 늦게 도착하면 개수를 틀어지게 할 수 있어 뺀다. 같은 이벤트를 두 번 처리하지 않도록 Delivery ID도 확인한다.
3) 잡 상태 대조(reconcile)
재전달로 풀리지 않는 경우도 있었다. 이미 성공한 잡 수십 개가 계속 queued로 보인 적이 있다. 비슷한 시각에 GitHub Status가 웹훅 관련 인시던트를 보고했다. 이 잡들의 queued 이벤트는 잡이 생성되고 1시간 넘게 지나 도착했다. 톰스톤 보존이 1시간이었으니 이벤트가 왔을 때 톰스톤은 이미 만료된 뒤였다. Webhook은 이 이벤트를 새 대기 잡으로 받아들였다.
팀은 일정 시간 상태가 바뀌지 않은 잡을 깃허브의 실제 상태와 대조하기로 했다.
- Webhook은 1분마다 10분 넘게 이벤트가 없는
queued·in_progress잡을 StateStore를 거쳐 Actions API로 조회하고 깃허브가 알려 준 상태로 갱신한다. 전이는 여기서도queued→in_progress→completed한 방향만 허용한다. 여전히 대기 중인 잡은 알림을 유지하고 조회 도중에 들어온 이벤트는 평소처럼 반영한다. - 조회에는 StateStore가 쓰던 깃허브 앱에
Actions: read권한을 더해 쓴다. 한 사이클에 가장 오래 확인하지 않은 잡부터 최대 50개를 본다. 조회는 시간당 3,000회로 묶여 레이트 리밋 안에 머문다.
이 로직을 배포하고 5분이 지나기 전에 완료된 잡 244개가 정리됐고 장기 대기 잡은 30개에서 4개로 줄었다. 다만 그날 오후에도 queued 이벤트가 70~112분 늦게 계속 도착했다. 잡 약 30개는 대조 대상이 되기 전까지 10분가량 알림을 울렸다. 팀은 --tombstone-ttl 기본값을 1시간에서 3시간으로 늘렸다. 3시간 넘게 늦은 이벤트가 만드는 오집계는 reconcile이 정리한다.
러너 사이징과 병목 찾기
잡별 러너 크기 추천
Collector가 잡 이름을 러너 파드의 리소스 사용량과 이어 줘서 잡이 실제로 쓴 CPU·메모리를 러너에 설정된 리소스 요청과 비교할 수 있다. 필요 이상으로 큰 러너는 자원을 낭비한다. 클러스터가 그 자원을 확보하는 동안 파드 스케줄링도 늦출 수 있다. 팀은 이 데이터로 잡마다 적당한 러너를 추천하는 대시보드를 운영한다.
ARC 컨트롤러 병목
또 다른 장애에서는 대기 시간 알림이 울렸고 Webhook 큐 대시보드에 큐가 쌓이는 모습이 보였다. 깃허브 장애 공지는 없었다. 러너 등록 설정(JIT config)을 받아 오는 호출도 지연 중간값이 0.57초로 정상이었다. 문제는 ARC에 있었다. 러너를 만들고 정리하는 것은 EphemeralRunner 컨트롤러인데, 이 컨트롤러의 워크 큐(workqueue_depth)가 평소보다 훨씬 높이 올라가 있었다.
이 큐를 처리하는 워커 수(controller_runtime_active_workers)는 6시간 동안 2에 머물렀다. 0.12.x 기준 runnerMaxConcurrentReconciles의 기본값이다. 그사이 p99 처리 시간은 0.9초에서 8~10초로 늘었다. 워커 둘에 깃허브 호출까지 느려지니 컨트롤러가 일을 제때 처리하지 못했다. 한 러너 스케일 세트에서는 러너 258개가 생성을 기다리는데 파드는 150개 정도만 있었다. 정리도 밀려서 이미 종료된 파드 95개와 삭제 중인 러너 55개가 계속 maxRunners에 계산됐다.
runnerMaxConcurrentReconciles를 2에서 5로 올리자 약 10분 안에 컨트롤러 큐가 669에서 233으로, 대기 잡이 380에서 168로, 러너 스케일 세트에서 대기하던 러너가 224에서 61로 줄었다. p99 처리 시간은 11초로 여전히 높았지만 동시성을 늘린 것만으로 백로그가 줄었다.
원문 근거
"We raised `runnerMaxConcurrentReconciles` from 2 to 5 to give the controller more throughput. Within about 10 minutes, the controller queue fell from 669 to 233, waiting Jobs went from 380 to 168, and Runners waiting in the Runner Scale Set dropped from 224 to 61."
Webhook의 잡 대기 시간 메트릭과 ARC 컨트롤러 메트릭을 나란히 놓고 본 덕분에 컨트롤러 처리량이 병목이라는 것을 짚어 냈다.
원문 근거
"Comparing Webhook's Job wait-time metrics with ARC's controller metrics had helped us identify controller throughput as the bottleneck."
ARC를 운영 중이라면 가져갈 것
익스포터 자체는 원문에 저장소 링크가 없어 그대로 설치할 수는 없다. 그래도 원문에 나온 것만으로 지금 운영 중인 ARC에서 확인해 볼 지점이 몇 가지 있다.
- 잡이 Queued에 쌓이는데 깃허브 장애 공지가 없다면
EphemeralRunner컨트롤러의workqueue_depth와controller_runtime_active_workers를 먼저 본다. 워커 수가runnerMaxConcurrentReconciles값에 붙어 있고 큐가 계속 자란다면 동시성 부족을 의심할 수 있다. 원문 기준 0.12.x의 기본값은 2다. - 종료된 파드와 삭제 중인 러너도
maxRunners에 계산된다. 정리가 밀리면 실제로 도는 러너가 한도보다 적어도 새 러너가 뜨지 못한다. 러너 수가maxRunners의 90%에 닿을 때 울리는 알림은 그래서 쓸모가 있다. - 웹훅으로 상태를 추적하는 도구를 직접 만든다면 세 가지를 전제로 둔다. 이벤트는 순서 없이 온다. 실패한 전달은 깃허브가 재시도해 주지 않는다. 한 시간 넘게 늦는 이벤트도 있다. 당근 팀은 단방향 상태 전이와 톰스톤, 전달 로그 기반 재전달, API 대조를 차례로 쌓아 이 셋에 대응했다.
- 보존 기간은 데이터 종류별로 나눈다. TTL 하나가 진행 중 잡, 톰스톤, 중복 제거 키, 스냅샷 복원 한도를 함께 정하면 스냅샷이 불어나고 낡은 상태가 복원된다.
- 대기 시간은 값이 아니라 시작 시각으로 내보내고
time() - <타임스탬프>로 계산한다. 익스포터가 값을 갱신할 필요가 없다.
맺으며
ARC를 직접 운영해도 GitHub Actions를 쓰는 한 깃허브 의존은 피할 수 없다. 당근 팀은 장애 때 개발자에게 상황을 알리려고 이 메트릭을 모으기 시작했는데 잡 상태가 보이자 러너 크기를 맞추고 지연과 병목의 원인을 추적하는 데까지 쓰게 됐다고 적었다.
참고
- 원문: Closing the GitHub Actions Monitoring Gap: Observing ARC Runners with an Exporter (당근 기술 블로그, Yoonho Hann)
- ARC 공식 문서: Actions Runner Controller
- ARC 저장소: actions/actions-runner-controller
- ARC 이슈 #4485: Add job metadata labels to runner pods when a job is assigned