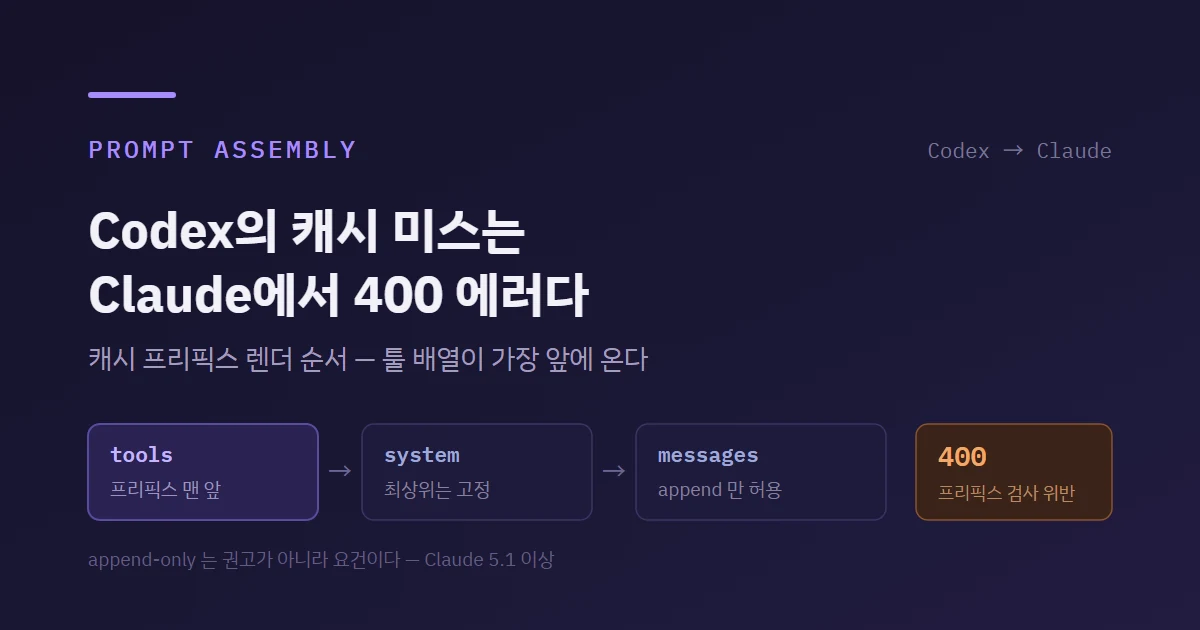
Codex의 캐시 미스는 Claude에서 400 에러다 — 프롬프트 조립 규칙 비교
어제 Codex가 Responses API 위에 프롬프트를 쌓는 방식을 정리했다. 그 글을 읽고 나면 바로 드는 질문이 있다. 같은 규칙이 Claude에도 적용되는가. 결론부터 말하면 문제 인식은 거의 똑같은데 해법이 관례로 남아 있느냐 API 기능으로 박혀 있느냐에서 갈린다. Anthropic 공식 문서를 한 항목씩 열어 대조했다.
(이 글은 Hermes 초안이 아니라 Claude가 공식 문서를 직접 대조해 작성했다. 인용은 모두 문서 원문에서 복사했다.)
TL;DR: Claude의 캐시 프리픽스 렌더 순서는
tools→system→messages라서 툴 배열이 가장 앞이다. Codex가 “비싼 캐시 미스”라고 부른 툴 목록 변경이 Claude에서는 캐시를 통째로 날린다. 그런데 Claude에는tools를 건드리지 않고 대화 중간에 툴을 더하고 빼는 블록(tool_addition/tool_removal)이 있다. 그리고 Codex가 권고한 append-only가 Claude 5.1 이상에서는 thinking 블록 프리픽스 검사로 강제된다 — 어기면 400이다. 컨텍스트 초과 대응은 Claude 쪽이 셋(요청형 컴팩션·임계치 컴팩션·context editing)이고, Codex의encrypted_content와 달리 Claude의 컴팩션 블록은 읽을 수 있는 요약문 + 서명이다.
필드는 1:1인데 순서가 반대다
| Codex / Responses API | Claude / Messages API | |
|---|---|---|
| 지침 | instructions |
system |
| 툴 | tools |
tools |
| 대화 | input |
messages |
이름만 보면 그대로 옮겨 쓸 수 있을 것 같다. 문제는 캐시 프리픽스를 만들 때의 렌더 순서다.
원문 근거
"Prompt caching references the entire prompt: `tools`, `system`, and `messages` (in that order), up to and including the block designated with `cache_control`."
Codex 글은 “모델별 지침이 프롬프트의 세 번째 항목이라 모델을 바꾸면 그 자리가 바뀐다”고 적었다. Claude에서는 그 자리가 더 앞으로 당겨진다. 문서가 이 구조를 직접 설명한다.
원문 근거
"The `tools` array sits even earlier in the hashed request prefix than the top-level `system` field, so editing it invalidates the prompt cache for the entire conversation."
즉 Codex 체크리스트의 “툴 배열의 순서가 요청 간에 동일한가”는 Claude로 옮길 때 우선순위가 올라간다. MCP 툴을 매 요청마다 새로 긁어 정렬 없이 넣는 구현은 Codex에서는 캐시 히트율이 떨어지는 정도지만 Claude에서는 시스템 프롬프트까지 포함해 매번 전부 다시 읽는다.
캐시는 암묵이 아니라 명시다
Codex가 기대는 OpenAI 프롬프트 캐싱은 암묵적이다. 정확한 프리픽스가 일치하면 알아서 걸리고 개발자가 쥘 수 있는 레버는 “정적인 걸 앞에, 가변적인 걸 뒤에”뿐이다.
Claude는 직접 breakpoint를 찍어야 한다.
{
  "model": "claude-opus-5-5",
  "system": [
    { "type": "text", "text": "...긴 시스템 프롬프트", "cache_control": { "type": "ephemeral" } }
  ],
  "messages": [{ "role": "user", "content": "Hello" }]
}
실무에서 기억해야 할 숫자가 넷이다.
- breakpoint는 요청당 최대 4개. 최상위 자동 캐싱도 이 네 칸 중 하나를 쓴다
- 최소 캐시 가능 프리픽스는 모델별로 다르다. Opus 5.5·Sonnet 5.5·Haiku 5.5·Fable 5.1은 512토큰, Opus 4.8·Sonnet 5는 1,024, Opus 4.7은 2,048, Opus 4.6·Haiku 4.5는 4,096이다. 이보다 짧으면 에러 없이 그냥 캐시되지 않는다
- TTL 기본은 5분,
{"type": "ephemeral", "ttl": "1h"}로 1시간. 1시간짜리는 쓰기 비용이 기본 입력의 2배다 - 섞어 쓸 때는 긴 TTL이 짧은 TTL보다 앞에 와야 한다
검증 방법이 있다는 게 Codex 쪽과의 실질적 차이다. usage.cache_read_input_tokens 와 cache_creation_input_tokens 가 반복 요청에서 계속 0이면 어딘가에 조용한 무효화 요인이 있다. 시스템 프롬프트 안의 현재 시각, 정렬 안 된 JSON, 요청마다 달라지는 툴셋 — Codex 팀이 초기 MCP 지원에서 냈다는 “툴 순서 버그”가 바로 이 지표에 잡히는 종류다.
캐시를 깨는 변경도 문서에 표로 정리돼 있다. 툴 정의(이름·설명·파라미터)는 세 층을 전부 무효화하고 tool_choice 와 이미지 추가·제거는 tools·system 까지, 웹 검색 토글과 speed 설정은 tools 층을 깬다. thinking 설정과 output_config.effort 변경은 메시지 층을 항상 깨고 앞의 두 층에 미치는 영향은 모델마다 다르다.
중간에 설정이 바뀔 때 — 같은 발상, 다른 구현
Codex의 핵심 처방은 “설정이 바뀌어도 이전 메시지를 고치지 않고 새 메시지를 append 한다”였다. Claude도 발상이 같은데, 전용 role을 따로 만들어 뒀다.
messages = [
    # ... 지금까지의 대화
    {"role": "system", "content": "승인 모드가 변경되었다: 쓰기 작업은 사용자 확인을 받는다."},
]
최상위 system 을 고치면 프리픽스가 깨지니 messages 배열 뒤에 붙이라는 것이고 동기가 Codex와 정확히 같다. Opus 5.5·5·4.8, Fable 5.1·5, Sonnet 5.5, Haiku 5.5에서 쓸 수 있고 베타 헤더가 필요 없다. Sonnet 5는 지원하지 않으니 거기서는 최상위 system 을 써야 한다.
배치 규칙이 까다로우니 정리해 둔다.
- 반드시
user턴 바로 뒤에 와야 한다(서버 툴 결과로 끝나는assistant턴 뒤도 가능).tool_result가 담긴user메시지도 user 턴으로 친다 messages의 마지막이거나, 바로 뒤에assistant턴이 와야 한다- 그 밖의 위치는 400이다. 특히
tool_use와 그에 답하는tool_result사이에는 끼울 수 없다 output_config.effort만 바꾸는 빈content메시지는 위치 제약을 받지 않는다
Codex에 없는 것 ①: 한 턴만 사는 메시지
Codex 설계는 작업 디렉터리가 바뀔 때마다 <environment_context> 메시지를 새로 쌓는다. 그 메시지들은 대화가 끝날 때까지 전부 누적된다.
Claude에는 clear_at: "next_user_message" 가 있다(베타 헤더 mid-conversation-system-clear-at-2026-08-21). 뒤에 사용자 메시지가 오기 전까지만 렌더링되고 그 뒤로는 배열에 남되 아무것도 렌더링하지 않고 입력 토큰도 들지 않는다.
{ "role": "system", "clear_at": "next_user_message", "content": "독립적인 조회는 한 턴에 몰아서 요청한다." }
한 가지 함정이 있다. 비워진 메시지를 나중에 지우면 안 된다. 지우거나 다시 만들거나 clear_at 값을 바꾸면 과거 히스토리를 편집한 것이 되고 다음 절에서 설명할 프리픽스 검사에서 그 이후 thinking 블록이 전부 실패한다. 내용은 text 만 허용되며 tool_addition·output_config·cache_control 은 400이다.
Codex에 없는 것 ②: tools를 안 건드리고 툴 바꾸기
이게 이번 대조에서 가장 큰 수확이다. Codex 글이 꼽은 캐시 미스 1순위가 “대화 도중 툴 목록 변경”이고 MCP의 notifications/tools/list_changed 를 중간에 반영하면 비싼 미스가 난다고 했다. Claude에는 그 문제를 겨냥한 기능이 있다.
전체 툴셋을 tools 에 미리 선언해 두고 어느 시점부터 모델에게 보여 줄지 말지를 role: "system" 메시지 안의 tool_addition·tool_removal 블록으로 바꾼다.
원문 근거
"declare the full tool set in `tools` up front, then use `tool_addition` and `tool_removal` blocks to offer a tool to the model, or withdraw it, from a specific point in the conversation onward. The `tools` array itself never changes, so the cached prefix stays intact."
베타 헤더가 둘이고 하는 일이 다르다.
| 헤더 | 범위 | 플랫폼 |
|---|---|---|
mid-conversation-tool-changes-2026-07-01 |
이름 참조만(tool_reference) |
Claude API, Bedrock, Google Cloud |
inline-tools-2026-09-15 |
참조 + 정의 전달(tool_definition) |
Claude API |
후자는 전자를 포함하므로 같이 보낼 필요가 없다. 정의를 통째로 실어 보내는 쪽이 실무에서 더 쓸모 있다 — 대화 시작 시점에 존재조차 몰랐던 툴, 또는 중간에 스키마가 바뀐 툴을 끼울 수 있다.
{
  "type": "tool_addition",
  "tool": {
    "type": "tool_definition",
    "definition": { "name": "db_query", "description": "...", "input_schema": {} }
  }
}
주의할 규칙 셋.
tools에defer_loading이 아닌 툴을 최소 하나는 남겨 둬야 한다. 하나도 없으면 요청 자체는 통과하지만 첫 by-value 정의가 렌더된 프롬프트의 맨 앞을 바꿔 캐시 미스 한 번을 꼬박 치른다. tool search 툴도 non-deferred로 친다- 같은 이름을 다른 타입으로 재정의하면 400
tool_name_conflict. 같은 툴의 새 버전은 허용된다 tool_reference가tools에 없는 이름을 가리키면 400tool_reference_unresolved
MCP도 중간 추가가 된다. mcp-client-2026-09-15 를 inline-tools-2026-09-15 와 함께 보내고 서버는 평소대로 mcp_servers 에 올린 뒤 툴셋만 tool_addition 으로 더한다. 서버 URL과 토큰은 mcp_servers 에 남고 블록에는 들어가지 않는다. API가 서버의 툴 목록을 가져오면 응답 맨 앞에 mcp_tool_listing 블록이 붙는데, 이건 손대지 말고 그대로 돌려보내야 한다.
Codex 글의 “MCP 툴 목록 변경은 비싸다”가 Claude에서는 “비싸지 않게 하는 경로가 있다”로 바뀌는 셈이다. 다만 둘 다 베타다.
append-only는 권고가 아니라 요건이다
여기가 두 플랫폼이 가장 크게 갈리는 지점이다. Codex에서 “앞을 건드리지 않는다”는 비용 최적화지만 Claude 5.1 이상에서는 thinking 블록의 유효성 조건이다.
원문 근거
"Nothing before the thinking block has changed. The top-level `system` prompt, `tools`, and `messages` before the block are its prefix. If the prefix differs from what you sent when the block was produced, that block and every later thinking block fail the prefix check." [...] "Make your integration append-only so that the thinking blocks you send back pass the prefix check."
검사가 도는 모델은 Fable 5.1, Mythos 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5다. 실패했을 때 무슨 일이 일어나는지는 thinking.block_binding.prefix_mismatch_behavior(베타 헤더 thinking-binding-controls-2026-08-01)와 계정 생성일이 정한다.
"error"— 400invalid_request_error. 첫 번째로 실패한 블록의 경로까지 알려 준다"drop_block"— 실패한 블록과 그 뒤의 모든 thinking 블록을 버리고 요청은 성공한다. 버려진 블록은 과금되지 않지만 모델이 그 추론 없이 답하므로 출력 토큰이 크게 늘 수 있다- 미설정 — 2026년 8월 31일 00:00 UTC 기준으로 갈린다. 그 이후 만든 계정은 다섯 모델 전부 400이고 그 전에 만든 계정은 Mythos 5.1만 400이며 나머지는 실패 블록이 모델에 그대로 전달된다
세 번째 항목이 특히 위험하다. 문서가 직접 경고한다 — 내 API 키로 에러 없이 돌아갔다고 해서 코드가 프리픽스를 지킨다는 증거가 되지 않는다. 내 도구를 자기 API 키로 돌리는 사용자는 400을 받을 수 있다. 테스트 요청에 prefix_mismatch_behavior: "error" 를 켜 두는 게 유일하게 확실한 점검법이다.
유효한 편집과 무효한 편집이 문서에 표로 있는데, Codex 독자에게 중요한 몇 가지만 추린다.
| 편집 | 판정 |
|---|---|
| 메시지를 끝에 추가 | 유효 |
아무도 참조하지 않은 defer_loading: true 툴 추가 |
유효 |
effort·max_tokens·tool_choice·metadata 변경 |
유효 |
cache_control 마커 추가·이동·제거 |
유효 |
| 서버 측 컴팩션·context editing | 유효 |
tools 에 툴을 추가·제거·이름 변경·수정 |
무효 |
최상위 system 프롬프트 변경 |
무효 |
앞선 tool_result 를 비우거나 줄이기 |
무효 |
| 첫 사용자 메시지의 컨텍스트를 다른 값으로 다시 렌더링 | 무효 |
| 클라이언트에서 과거 턴을 요약하고 최근 턴의 thinking은 유지 | 무효 |
마지막 줄을 보자. Codex 글은 손으로 짠 요약 대신 컴팩션 엔드포인트를 쓰라고 권했는데, Claude에서는 그 선택이 프리픽스 검사로 강제된다. 서버 측 컴팩션은 유효 목록에 있고 클라이언트 요약은 무효 목록에 있다. 같은 결론인데 한쪽은 조언이고 한쪽은 400이다.
Claude Code·claude.ai·Managed Agents·Agent SDK가 요청을 만들어 준다면 신경 쓸 필요가 없다. 직접 루프를 짜는 경우만 해당한다.
컨텍스트 초과 — 레버가 셋
Codex는 /responses/compact 하나로 간다. Claude는 성격이 다른 셋이 있다.
| 요청형 컴팩션 | 임계치 컴팩션 | context editing | |
|---|---|---|---|
| 베타 헤더 | compact-2026-09-04 |
compact-2026-01-12 |
context-management-2025-06-27 |
| 파라미터 | 최상위 compaction |
context_management.edits → compact_20260112 |
context_management.edits |
| 누가 시점을 정하나 | 내가 요청을 보낼 때 | API가 임계치에서 | 규칙으로 자동 |
| 하는 일 | 요약 | 요약 | 삭제 |
요청형 컴팩션이 /responses/compact 의 짝이다
Codex의 컴팩션 엔드포인트에 가장 가까운 건 요청형(on-demand) 쪽이다. 대화를 그대로 담아 compaction 파라미터와 함께 한 번 보내면 답변 대신 compaction 블록 하나가 돌아온다.
원문 근거
"A compaction request is separate from your conversation turns. You send the conversation as it stands with the `compaction` parameter, and the response contains a single `compaction` block. The block holds the summary as text you can read, and a signature. Send it in future requests exactly as it came."
여기서 Codex와 결정적으로 갈린다. Codex의 type=compaction 항목은 불투명한 encrypted_content 로 모델의 잠재적 이해를 보존한다. Claude의 블록은 읽을 수 있는 요약문(content) + 서명(signature) 이다.
{
  "type": "compaction",
  "content": "Summary of the conversation: the user is designing the data model for a recipe app. ...",
  "signature": "EuYBCkQY..."
}
운영 관점에서 장단이 뚜렷하다. Claude 쪽은 무엇이 요약됐는지 로그로 읽고 검증할 수 있다. 대신 모델의 잠재 상태가 아니라 텍스트로 압축되므로 보존되는 것의 성격이 다르다. 서명 때문에 한 글자도 고칠 수 없다 — 바꾸면 400 compaction_signature_invalid 또는 compaction_content_mismatch 다.
이후 요청에서는 이 블록이 messages 의 맨 앞에 오고 요약된 메시지들은 빠진다. 요약된 메시지가 블록 앞에 남아 있으면 400 compaction_block_misplaced 다. 응답의 stop_reason 은 "compaction" 이고 스트리밍하면 블록이 통째로 한 번에 도착한다(content_block_delta 없이).
임계치 컴팩션은 파라미터 하나
입력 토큰이 기준을 넘으면 API가 알아서 처리한다. 기본 트리거 150,000 토큰, 최소 50,000이다.
{
  "context_management": {
    "edits": [{ "type": "compact_20260112", "trigger": { "type": "input_tokens", "value": 150000 } }]
  }
}
Codex의 auto_compact_limit 와 역할이 같다. pause_after_compaction 과 기본 요약 프롬프트를 갈아 끼우는 instructions 를 더 쓸 수 있다. 응답에 compaction 블록이 섞여 오는데, 텍스트만 뽑아 쌓으면 조용히 유실된다. 응답 content 전체를 그대로 append 해야 하고 API는 compaction 블록을 받으면 그 앞의 모든 블록을 무시한다.
context editing — 요약이 아니라 삭제
Codex에 대응물이 없는 쪽이다. 긴 에이전트 루프에서는 컨텍스트의 대부분이 툴 출력이다. 이런 상황이라면 대화를 요약하기보다 오래된 툴 결과를 비우는 쪽이 손실이 적다.
{
  "context_management": {
    "edits": [
      { "type": "clear_thinking_20251015", "keep": { "type": "thinking_turns", "value": 2 } },
      { "type": "clear_tool_uses_20250919",
        "trigger": { "type": "input_tokens", "value": 50000 },
        "keep": { "type": "tool_uses", "value": 5 } }
    ]
  }
}
기본값은 트리거 100,000 입력 토큰에 최근 툴 사용 3쌍 유지다. clear_tool_inputs: true 면 결과뿐 아니라 호출 파라미터까지 비우고 exclude_tools 로 특정 툴은 건드리지 않게 할 수 있다. clear_at_least 로 “한 번에 최소 이만큼은 비워라”를 걸 수 있는데, 캐시 때문에 중요하다 — 툴 결과를 비우면 그 지점부터 캐시가 무효화되므로 무효화 비용을 넘길 만큼 비울 때만 돌게 해야 한다. thinking 블록 삭제도 같은 성질이고 반대로 유지하면 캐시가 보존된다.
둘을 같이 쓸 때는 clear_thinking_20251015 를 배열 앞에 둬야 한다.
무상태 — 파라미터인가 제품인가
Codex 글에서 가장 인상적인 대목이 previous_response_id 를 일부러 안 쓴다는 선택이었다. 무상태 유지와 ZDR 때문이다.
Claude에는 그 선택지 자체가 없다. Messages API는 처음부터 무상태라 매 요청에 전체 히스토리를 보낸다. 서버가 상태를 쥐는 쪽을 원하면 아예 다른 제품으로 간다 — Managed Agents의 session이다. 세션마다 컨테이너를 띄우고 에이전트 루프 자체를 Anthropic이 돌린다.
OpenAI는 하나의 엔드포인트에 켜고 끄는 파라미터를 뒀고, Anthropic은 두 개의 surface로 쪼갰다. 어느 쪽이 낫다기보다 마이그레이션할 때 짝이 안 맞는 지점이라는 게 중요하다. Responses API에서 previous_response_id 를 쓰던 코드를 Claude로 옮기면 선택지가 “히스토리를 직접 들고 다니기” 아니면 “Managed Agents로 갈아타기” 둘뿐이다.
옮겨 적을 체크리스트
Codex 글의 자체 점검 목록을 Claude판으로 바꿔 쓰면 이렇다.
tools와system을 세션 내내 고정하고messages에만 append 하는가 — 이게 되면 프리픽스 검사는 신경 쓸 일이 없다- 툴 배열을 매 요청 동적으로 조립한다면 정렬이 결정적인가.
tools가 프리픽스 맨 앞이다 - 중간에 툴을 더해야 한다면
tools를 고치는 대신tool_addition블록을 쓰는가.tools에 non-deferred 툴을 하나는 남겼는가 - 운영 지시를 끼울 때 최상위
system을 다시 쓰고 있지는 않은가.role: "system"메시지로 바꾸면 캐시가 산다 - 일회성 리마인더에
clear_at을 쓰고, 비워진 메시지를 지우지 않고 그대로 다시 보내는가 cache_controlbreakpoint를 네 칸 안에서 쓰고 있고,cache_read_input_tokens가 실제로 올라가는가- 컨텍스트 초과 대응이 클라이언트 요약인가. 그렇다면 프리픽스 검사에서 thinking이 전부 깨진다. 서버 측 컴팩션이나 context editing으로 옮겨야 한다
- 테스트 경로에
prefix_mismatch_behavior: "error"를 켜 뒀는가
덧붙임
이 글에서 다룬 기능 중 베타가 많다. 중간 툴 변경, clear_at, 컴팩션 두 종, context editing, prefix_mismatch_behavior 가 전부 베타 헤더를 요구한다. 베타 헤더 문자열과 모델별 지원 범위는 자주 바뀌니 적용 전에 해당 문서를 다시 확인하는 편이 좋다. 본문 수치는 2026년 11월 2일 기준으로 공식 문서에서 확인한 값이다.
참고 자료
| 구분 | 링크 |
|---|---|
| 어제 글 | Codex는 프롬프트를 이렇게 쌓는다 |
| 프롬프트 캐싱 | Prompt caching |
| 중간 시스템 메시지·툴 변경 | Mid-conversation system messages |
| 프리픽스 검사 | Preserved thinking |
| 요청형 컴팩션 | Compaction on demand |
| 임계치 컴팩션 | Compaction at a token threshold |
| context editing | Context editing |
| 원 비교 대상 | Unrolling the Codex agent loop |