멀티턴 툴 사용 RL, 어느 턴을 학습할지부터 진단한다 — Salesforce Critical-State RL
Salesforce AI Research의 논문 「Critical-State RL: Diagnosing Trainable States for Multi-Turn Tool Use」(arXiv:2609.24985, 2026-09-21 제출)를 읽고 정리했다. 멀티턴 에이전트를 강화학습으로 다듬을 때 “어느 턴을 학습시킬 것인가”를 감이 아니라 진단으로 정하자는 제안이다. DAIR.AI가 트윗으로 소개하면서 알려졌다. (이 글의 초안은 설치된 Hermes 에이전트가 작성했고, Claude가 검수 후 발행했다.)
TL;DR: 멀티턴 툴 사용에서 실패는 대개 한 번의 호출에 달려 있다. 그런데 보상이 크게 흔들린다고 해서 그 턴이 학습할 만한 턴은 아니다. 뒤에서 벌어지는 일의 무작위성이 섞여 들어오기 때문이다. Critical-State RL은 행동 충분성·개선 여지·학습 가능성 세 조건으로 학습할 상태를 고르고, 중첩 샘플링으로 행동이 만든 차이와 이후 진행의 잡음을 분리한 뒤, 고른 지점에서만 컨텍스추얼 밴딧으로 학습한다. BFCL v4
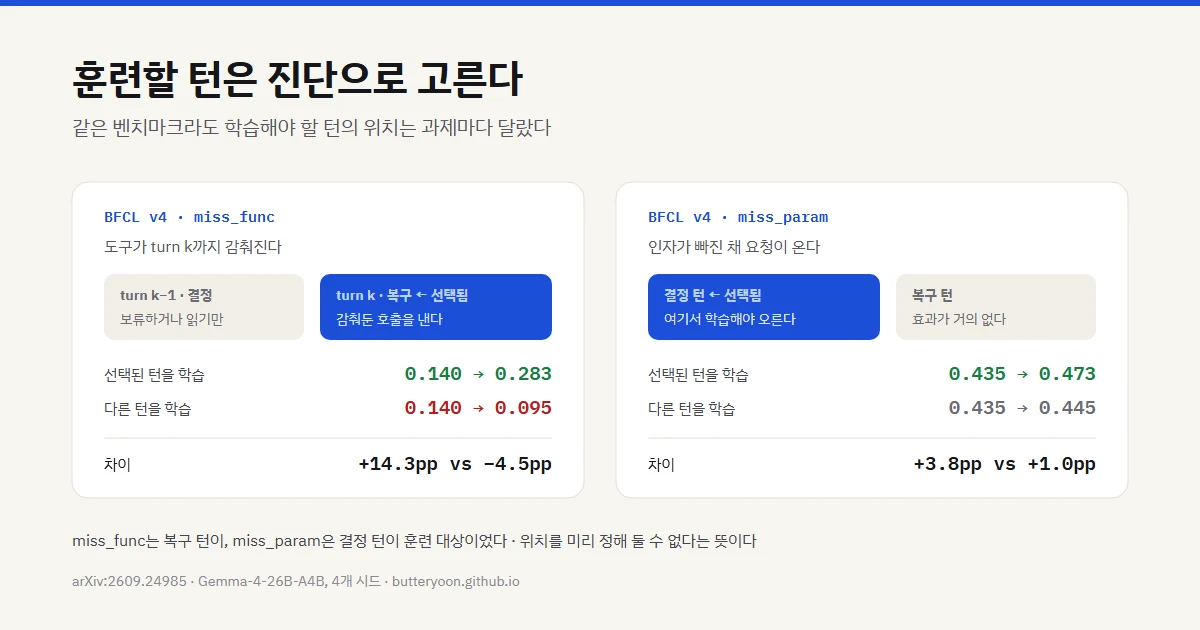
miss_func에서 선택된 턴을 학습하면 0.140 → 0.283(+14.3pp), 다른 턴을 학습하면 0.140 → 0.095(−4.5pp)였다. 중요한 건 그 턴의 위치가 과제마다 달랐다는 점이다.
1. 문제: 보상이 흔들린다고 학습할 턴은 아니다
멀티턴 툴 사용에서는 최종 성공 여부가 중간의 한 호출에서 갈리는 경우가 많다. 그렇다면 그 호출을 찾아 집중적으로 학습시키면 될 것 같다. 문제는 어느 호출인지 알아내는 방법이다.
가장 손쉬운 단서는 보상의 변동이다. 그 턴에서 다른 행동을 했을 때 결과가 크게 달라졌다면 중요한 턴처럼 보인다. 논문은 이 단서가 믿을 게 못 된다고 지적한다. 보상이 이후 상호작용에 의존할 때, 변동은 지금 행동의 차이가 아니라 뒤에서 벌어진 일의 무작위성을 반영할 수 있기 때문이다.
원문 근거
"Multi-turn tool-use failures can hinge on a single model call, yet reward variation alone does not reveal which call would benefit from training. When rewards depend on later interactions, their variation can reflect downstream randomness rather than differences between the current actions."
2. 세 가지 진단 조건
논문은 학습할 만한 상태(critical state)를 정의 1에서 세 조건으로 규정한다. 셋을 모두 만족해야 한다.
- 행동 충분성(action-sufficiency): 맥락과 국소 라벨이 주어졌을 때 최종 보상이 그 행동과 조건부 독립이 아니어야 한다. 즉 지금의 보상이 이 행동이 과제 성공에 미친 영향을 실제로 담고 있는가를 본다.
- 개선 여지(headroom): 최선의 행동이 내는 값이 기준 정책의 평균보다 의미 있게 높아야 한다. 이미 잘하고 있는 지점을 더 학습시켜 봐야 얻을 게 없다.
- 학습 가능성(trainability): 현재 정책이 내놓는 행동들 사이에 값의 차이가 있어야 한다. 모든 행동이 똑같은 결과를 낸다면 학습 신호가 없다.
정리하면 “이 보상이 정말 이 행동 때문인가, 더 잘할 여지가 있는가, 지금 정책이 그 차이를 만들어 낼 수 있는가” 세 가지를 차례로 묻는 것이다.
3. 중첩 샘플링 — 신호와 잡음 분리
세 조건을 실제로 재려면 행동이 만든 차이와 이후 진행의 잡음을 갈라야 한다. 논문은 중첩 샘플링(nested sampling)을 쓴다.
- 정책 접두사(prefix)를 하나 샘플링한다
- 그 고정된 접두사에서 후보 행동들을 뽑는다
- 각 행동을 고정한 채 그 뒤의 진행만 다시 샘플링한다
이렇게 하면 행동별 평균과 같은 행동 안에서의 변동을 따로 얻는다. 앞의 것이 신호, 뒤의 것이 잡음이다.
원문 근거
"Sample a policy prefix, draw candidate actions at that fixed prefix, then hold each action fixed while resampling its reward-only continuation. Action means and within-action variation separate signal from continuation noise."
선택된 상태에서의 학습은 컨텍스추얼 밴딧으로 한다. 궤적 전체를 타고 흐르는 크레딧 배분 대신, 고른 지점의 단발 결정 문제로 바꾸는 셈이다.
4. 결과 — 학습할 턴의 위치는 과제마다 달랐다
평가는 BFCL v4 multi_turn 스위트(base, miss_func, long_context, miss_param)에서 이뤄졌다. 기본 모델은 Gemma-4-26B-A4B(no-think), 시드 4개로 결정적 평가를 했다.
miss_func는 필요한 도구를 turn k까지 감춰 두는 과제다. 실질적인 사용자 요청은 turn k−1에 나오고, turn k에는 빈 사용자 메시지가 오는데 하니스가 이를 도구 사용 가능 안내로 바꿔 넣는다. 그래서 두 후보 턴이 생긴다. turn k−1이 결정 턴(보류하거나 읽기 전용 질의를 해야 한다), turn k가 복구 턴(감춰 뒀던 호출을 낸다)이다.
| 스위트 | 진단이 고른 턴 | 선택된 턴 학습 | 다른 턴 학습 |
|---|---|---|---|
miss_func |
복구 턴 | 0.140 → 0.283 ±0.015 (+14.3pp) | 0.140 → 0.095 (−4.5pp) |
miss_param |
결정 턴 | 0.435 → 0.473 ±0.010 (+3.8pp) | 0.435 → 0.445 (+1.0pp) |
이 표에서 읽어야 할 것은 14.3pp라는 숫자보다 고른 턴이 서로 반대라는 사실이다. miss_func에서는 복구 턴이, miss_param에서는 결정 턴이 학습 대상으로 뽑혔다. “중요한 건 항상 결정하는 순간”이라거나 “실행하는 순간”이라고 미리 정해 둘 수 없다는 뜻이고, 진단 절차가 필요한 이유가 여기 있다.
잘못 고르면 손해라는 점도 분명하다. miss_func에서 결정 턴을 학습시킨 쪽은 출발점보다 4.5pp 떨어졌다.
5. 한계 — 논문이 직접 밝힌 것
원문 근거
"The four-cell study tests categorical turn selection rather than calibrating variance magnitudes or diagnostic thresholds. Repeat-call, Nemotron, and memory are applications rather than matched tests of the diagnostic or design choices... The recurrence and drift results are conditional."
- 네 칸짜리 비교 실험은 “어느 턴을 고를 것인가”라는 범주적 선택만 검증한다. 분산의 크기나 진단 임계값을 보정한 것이 아니다.
- 반복 호출, Nemotron-Super-120B, 메모리 관련 결과는 적용 사례이지 진단이나 설계 선택을 맞대어 검증한 실험이 아니다.
- 재발·드리프트 결과는 조건부다.
즉 “진단으로 고르는 편이 낫다”까지는 보였지만, “이 임계값으로 고르면 된다”는 아직 아니다.
6. 적용 관점
멀티턴 툴 체인을 RL로 다듬을 계획이 있다면 가져갈 만한 것은 기법 자체보다 순서다. 보상 신호를 설계하기 전에 “지금 이 턴의 보상 변동이 정말 이 행동 때문인가”를 먼저 재 보라는 것이다. 이 질문을 건너뛰면 뒤쪽 무작위성을 학습하게 되고, 위 표처럼 출발점보다 나빠질 수 있다.
읽기 전용 호출과 상태 변경 호출을 구분해 두면 후보 턴을 좁히는 데 도움이 된다. 다만 이건 논문이 제시한 절차가 아니라 일반적인 설계 상식이고, 진단 자체를 대체하지는 못한다. 논문의 요지는 그 구분을 포함해 어떤 휴리스틱도 과제마다 정답이 달라진다는 쪽에 가깝다.
평가 지표와 실제 개선을 혼동하지 않는 문제라는 점에서는 검증기 품질이 환경 개수를 이긴다는 RIVER 논문과 같은 계열이다. 그쪽이 “환경의 보상이 맞는가”를 물었다면, 이쪽은 “그 보상을 어느 턴에 줄 것인가”를 묻는다.
7. 참고 자료
- 원문 논문: Critical-State RL: Diagnosing Trainable States for Multi-Turn Tool Use — Zixiang Chen, Wenting Zhao, Zhepeng Cen, Akshara Prabhakar, Jielin Qiu, Jianguo Zhang, Zhiwei Liu, Tulika Manoj Awalgaonkar, Liangwei Yang, Shelby Heinecke, Silvio Savarese, Huan Wang (Salesforce AI Research, 2026-09-21)
- 소개 트윗: DAIR.AI
- 벤치마크: Berkeley Function Calling Leaderboard v4, multi_turn 스위트(base / miss_func / long_context / miss_param)
- 관련 글: 터미널 에이전트 RL — 검증기 품질이 환경 개수를 이긴다